核心结论:PSEC(Parametric Skill Expansion and Composition)把每项技能编码为即插即用的 LoRA 模块、挂载在冻结的预训练策略上,构建可持续扩展的技能库;再通过上下文感知组合网络,在参数空间中按当前状态动态融合多个技能来解决新任务。该框架从机制上规避了灾难性遗忘,在 DSRL 安全离线强化学习、DeepMind Control Suite 持续策略漂移与 D4RL 动力学漂移三类场景中,全面优于动作级/噪声级组合及主流基线,新技能学习仅需 10 条演示与不到 5 万步梯度更新。
问题背景:工业模型的“从零重训”与“灾难性遗忘”困境
真实的工业设备在长期运行中,会因环境更替与机械摩擦损耗而发生动力学特性的缓慢漂移,这是导致传统工业模型在部署数月后极易出现“性能退化与失效”的主因。而学术界的主流决策算法同样面临这一困境:大多数方法遵循“从零训练”(tabula rasa)范式,不利用任何先验知识,一旦任务发生变化就要付出巨大的样本与计算代价。已有的持续学习、组合策略与微调类方法,则始终未能同时解决两个关键局限:
- 灾难性遗忘:缺乏保证能力持续增长的底层机制,学习新技能时极易过拟合新任务并遗忘旧技能;
- 新任务学习效率低下:采用参数隔离规避遗忘的方法,又无法利用旧技能中的先验知识加速新任务学习,技能越多、训练成本越高。
人类智能的启示恰好相反:人擅长复用已有技能应对新挑战,并在解决问题的过程中持续发展新技能。臻效智能团队提出的 PSEC 框架正是沿这一思路构建的,相关论文被全球人工智能顶级会议 ICLR 2025 收录:
- Liu, T., et al. Skill Expansion and Composition in Parameter Space. ICLR 2025.
核心方法:参数空间中的技能扩展与组合(PSEC)
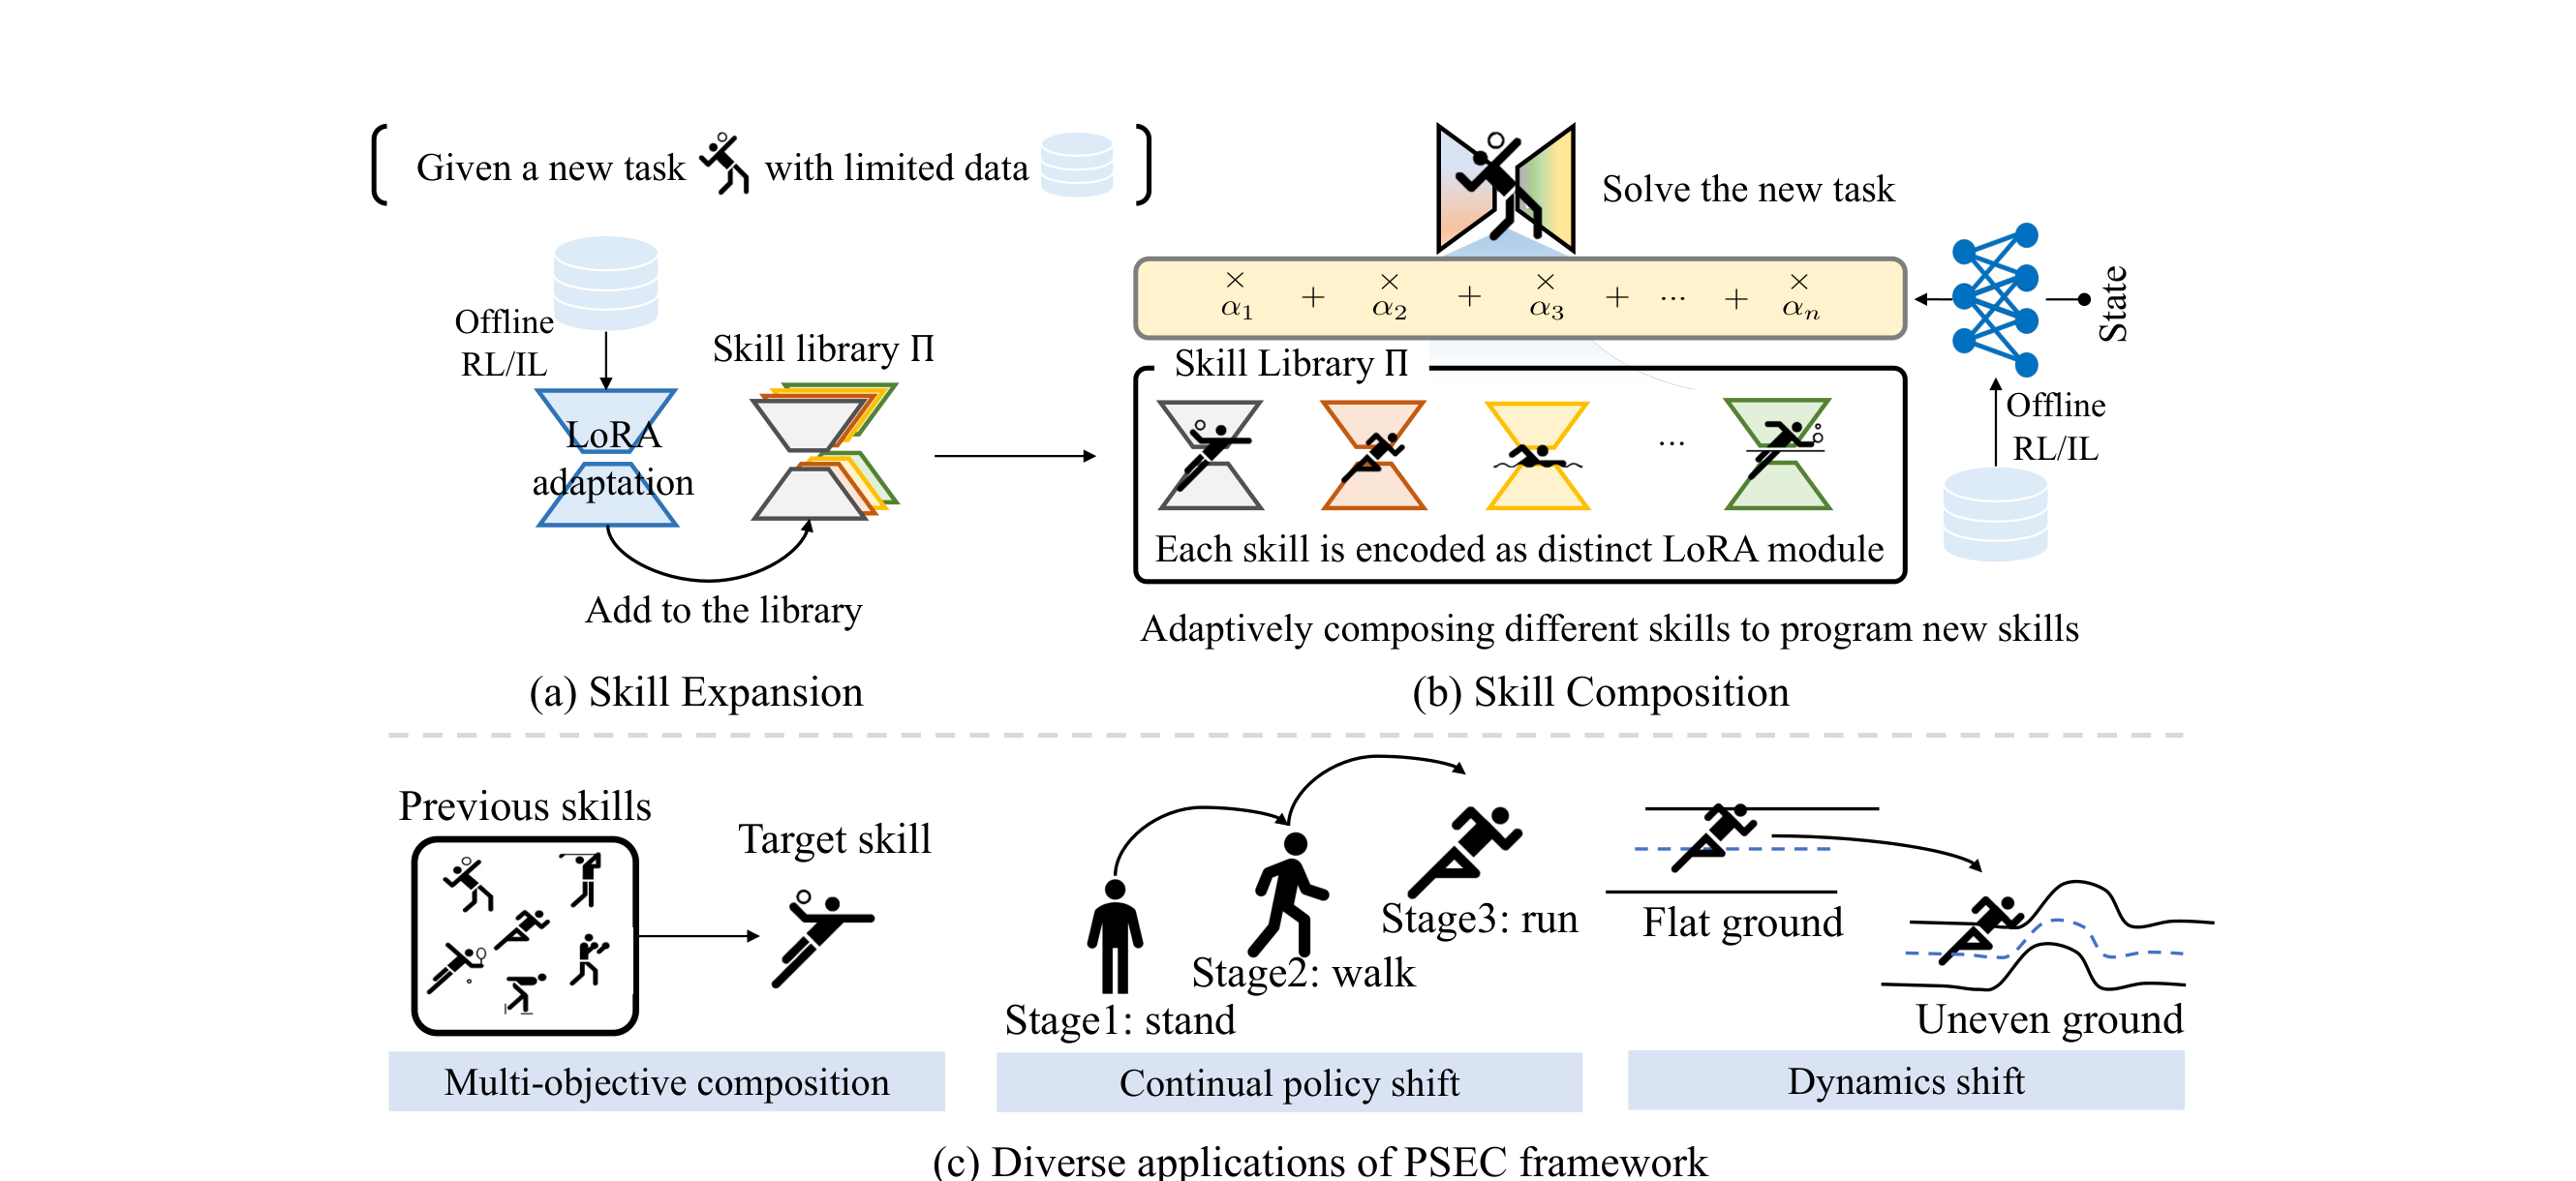
PSEC 的总体设计是维护一个可持续扩展的技能库 Π = {π₀, π₁, π₂, ...}:每项技能被编码为一个独立的 LoRA 模块,即插即用地挂载在冻结的预训练策略之上;面对新任务时,一个上下文感知(context-aware)组合网络根据当前状态动态融合库中技能,在参数空间中直接“编程”出新技能。每个技能基元都由扩散模型(diffusion model)建模,以保证组合行为的表达能力。
技能扩展:把新技能学进低秩参数模块
给定预训练策略 π₀ 及其权重矩阵 W₀,PSEC 不直接微调 W₀,而是引入可训练的低秩分解模块 ΔW = BA(秩 n 远小于原始维度),前向计算变为 (W₀ + αBA)h。这一设计带来三重收益:
- 机制性规避灾难性遗忘:W₀ 全程冻结,新技能只写入独立的 LoRA 参数,参数隔离让旧技能完全不受影响;
- 极低的适配成本:低秩结构大幅压缩可训练参数量,在只有少量目标技能数据时也不易过拟合;
- 可管理的技能资产:不同技能对应不同 LoRA 模块 {ΔWᵢ = BᵢAᵢ},可以灵活地加入技能库、移除次优基元,实现技能的“资产管理”。
更重要的是,LoRA 模块的线性插值性质使技能融合可以直接在参数空间完成:W = W₀ + Σᵢ αᵢBᵢAᵢ——调节组合权重 αᵢ 就能在预训练技能与多个技能基元之间插值出新技能。
技能组合:上下文感知的动态加权
静态场景下固定的组合权重或许够用,但决策场景需要实时调整:就像自动驾驶中,接近障碍时应优先调用避障技能、巡航时应优先调用加速技能。PSEC 为此设计了上下文感知组合网络 α(s; θ),根据智能体当前状态 s 动态输出各技能的组合权重:W(θ) = W₀ + Σᵢ αᵢ(s; θ)BᵢAᵢ。训练时只有组合网络的参数 θ 需要优化,W₀ 与全部 LoRA 模块保持冻结——组合学习在样本与参数两个维度都极为高效。
为什么是参数空间:与动作级、噪声级组合的对比
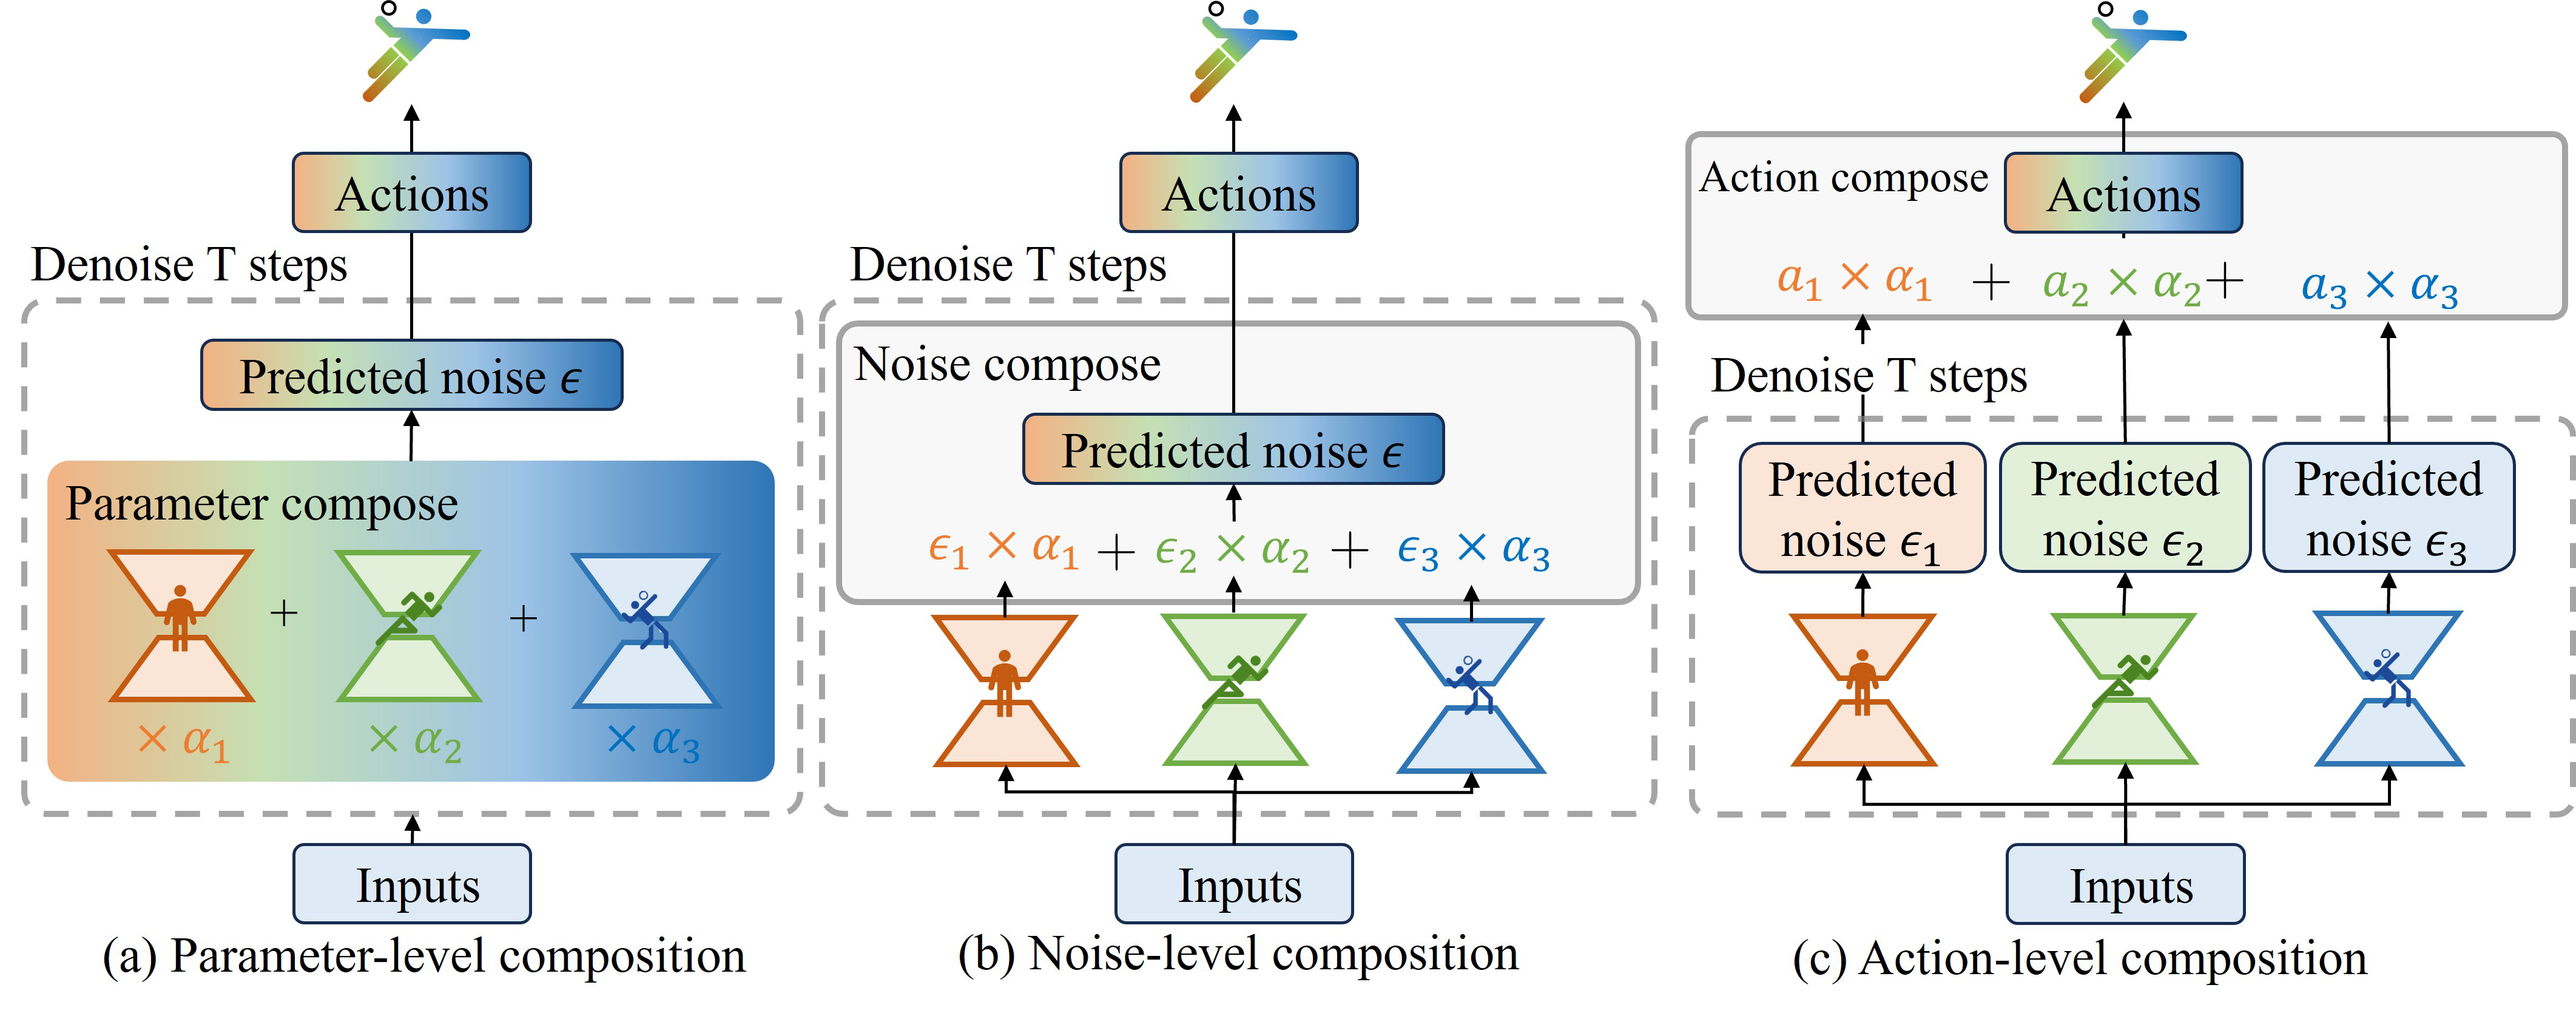
以往的技能组合发生在更“靠后”的阶段:动作级组合(ASEC)在各技能生成动作分布之后再做加权,噪声级组合(NSEC)在扩散采样的噪声预测上做固定权重的合并。PSEC 的参数级组合则是一种“早融合”——在生成最终策略分布之前,就充分利用不同技能之间共享与互补的结构信息。论文的 t-SNE 可视化进一步证实:参数空间中不同技能既共享公共知识、又保留各自的可区分特征,而噪声空间过于嘈杂、动作空间则丢失了技能间的共享结构。
多目标组合验证:安全、收益与分布偏移的三目标平衡
许多真实任务天然是多目标的。论文在安全离线强化学习基准 DSRL 上构造了一个“三目标”难题:同时避免分布偏移、最大化收益、最小化安全代价。PSEC 的解法是训练三个技能基元——行为策略 π₀、收益导向技能 π₁(以优势函数加权)与安全导向技能 π₂(以可行价值函数加权),再用少量近专家演示训练上下文感知组合网络来动态调和三者。相比之下,传统安全离线 RL 方法依赖人工调好的固定权衡系数,本质上等价于“固定组合权重”。
| 方法 | MetaDrive 平均收益 ↑ | MetaDrive 平均代价 ↓ | BulletGym 平均收益 ↑ | BulletGym 平均代价 ↓ |
|---|---|---|---|---|
| BC | 0.40 | 3.21 | 0.72 | 10.58 |
| CDT | 0.25 | 1.45 | 0.63 | 2.09 |
| FISOR(SOTA 安全离线 RL) | 0.36 | 0.25 | 0.39 | 0.10 |
| NSEC(噪声级组合) | 0.53 | 0.76 | 0.62 | 4.24 |
| ASEC(动作级组合) | 0.67 | 2.02 | 0.58 | 3.20 |
| PSEC | 0.50 | 0.03 | 0.41 | 0.33 |
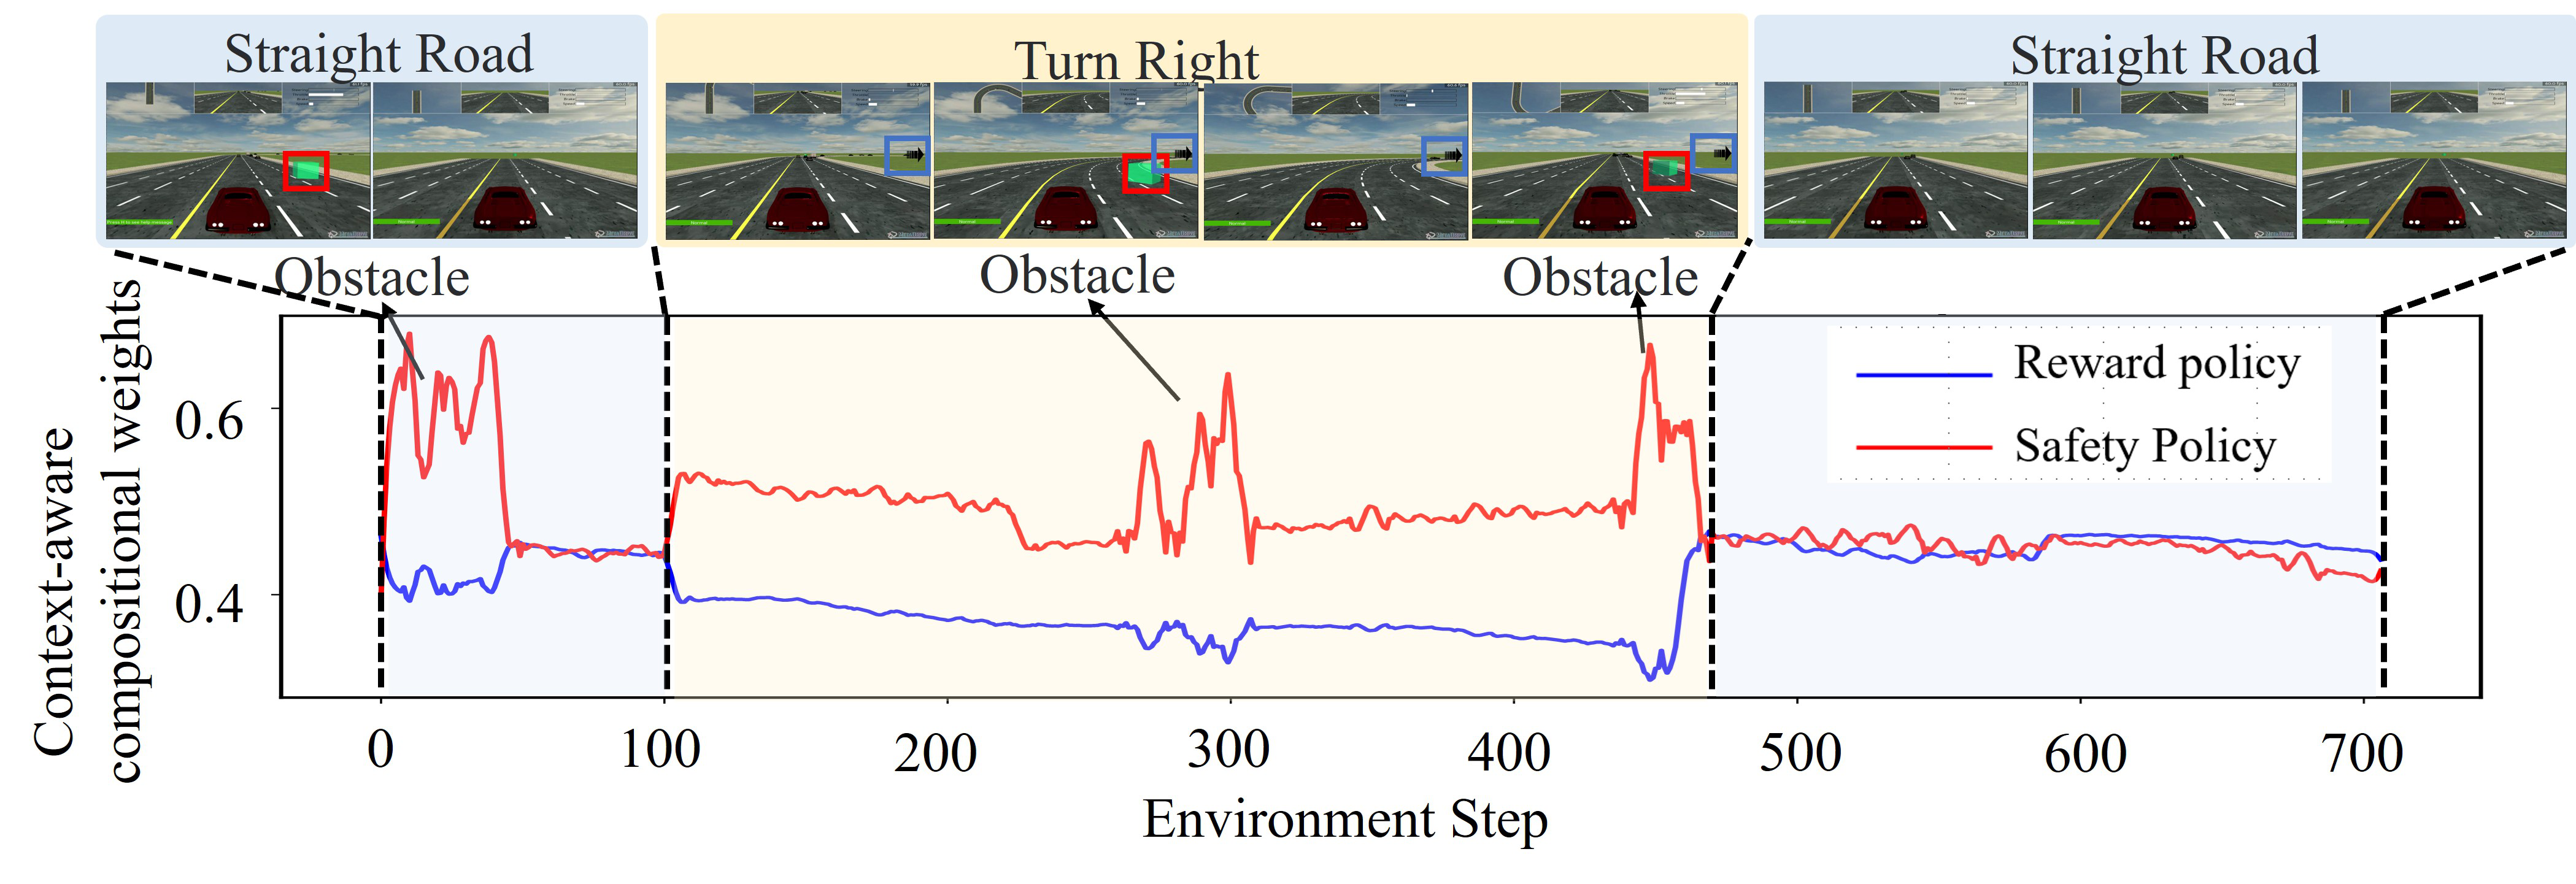
结果显示:噪声级与动作级组合都呈现“偏科”行为——收益和安全不可兼得;传统安全离线 RL 方法中表现最好的 FISOR 虽然安全,但收益明显偏低;只有 PSEC 在两个基准上同时取得高回报与近零安全代价。对组合网络输出的可视化进一步揭示了其工作方式:当车辆接近障碍物或转弯压线时,网络自动调高安全技能的权重;当路况平直、任务只是直行时,权重则转向收益最大化——动态组合相对于固定组合的必要性由此得到直接证明。
持续策略漂移验证:技能库越大,新技能学得越快
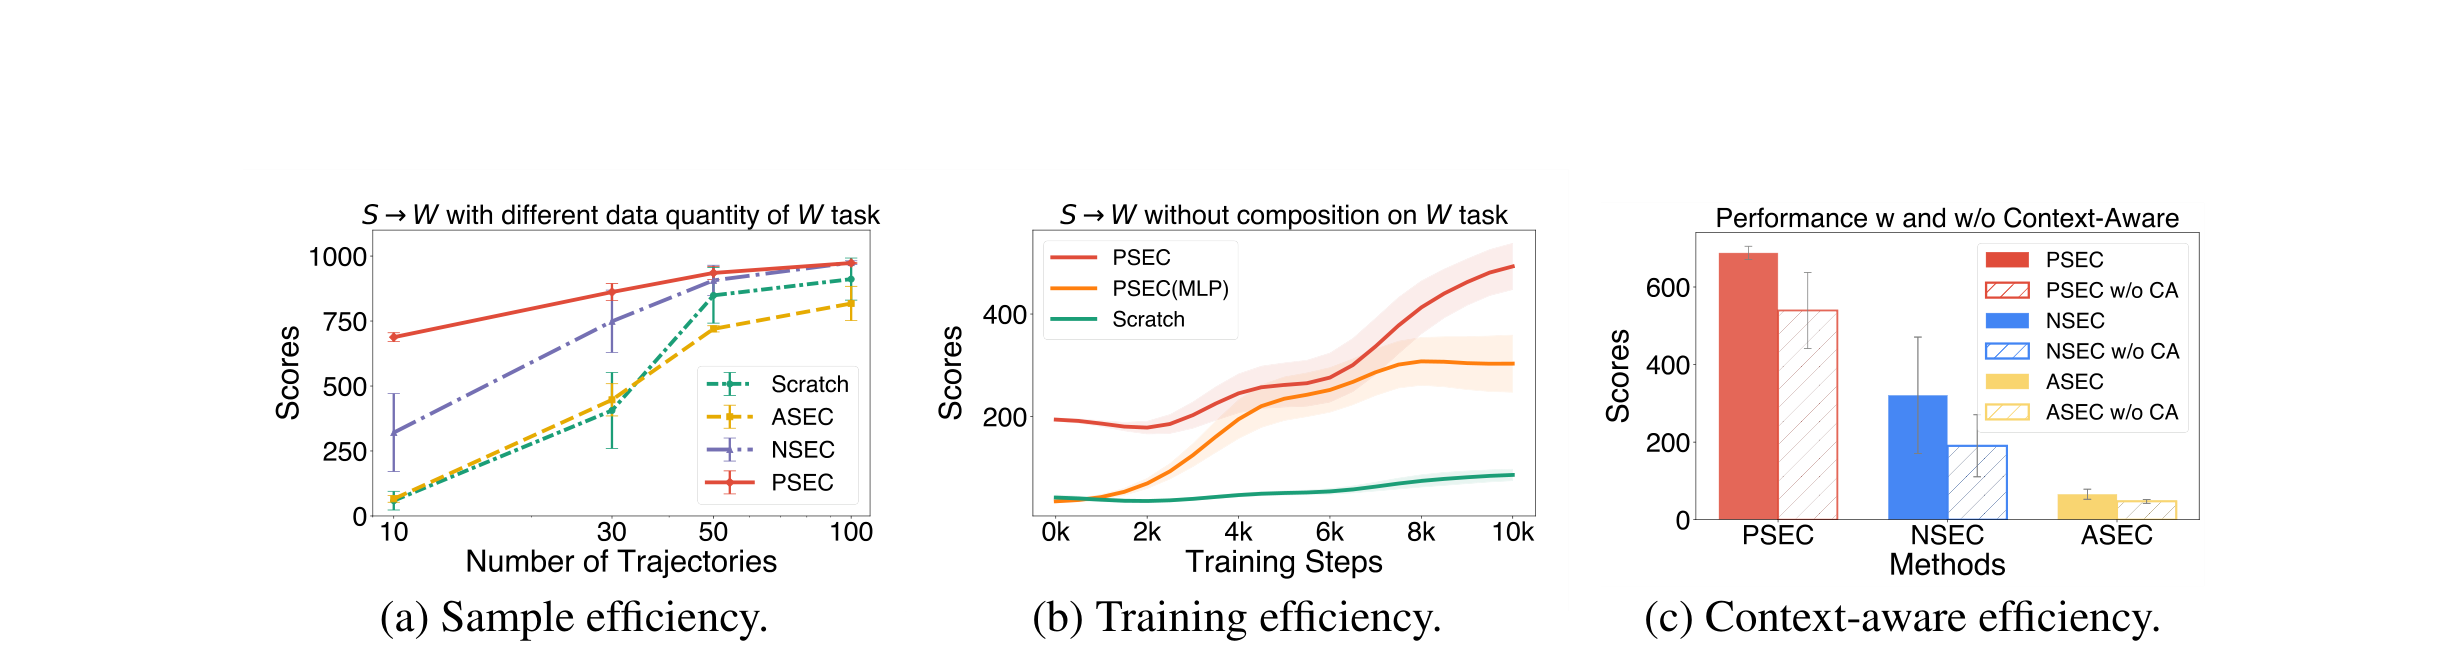
在 DeepMind Control Suite 上,论文让智能体依次学习站立(stand)、行走(walk)与奔跑(run):先用专家数据预训练站立技能 π₀,随后各提供仅 10 条专家轨迹学习行走与奔跑。这一设定检验两个问题:LoRA 技能扩展是否高效,以及技能库的增长能否持续增强学习能力。
| 方法 | S→W(学行走) | S→R(学奔跑) | S+W→R(站+走→跑) |
|---|---|---|---|
| 从零训练 | 58.9 | 25.5 | 25.5 |
| ASEC | 65.7 | 24.3 | 30.8 |
| NSEC | 320.9 | 38.5 | 39.4 |
| PSEC(MLP 变体) | 424.1 | 143.3 | 194.5 |
| PSEC | 688 | 221 | 247 |
三个观察值得强调:其一,PSEC 全面大幅领先,从零训练或把 LoRA 换成 MLP 都无法在 10 条轨迹下学会新技能;其二,S+W→R 优于 S→R——随着技能库扩充,智能体学习新技能的能力在持续进化;其三,即使把组合网络换成 MLP,PSEC(MLP) 依然超过 NSEC 与 ASEC,说明参数级组合本身就有结构性优势。效率方面,PSEC 在数据最稀缺(10 条轨迹)时优势最大,几乎所有任务只需不到 5 万步梯度更新即可完成训练,而以往方法通常需要百万步量级;上下文感知组合在各组合层级上也一致优于精心调参的固定组合。
动力学漂移验证:摩擦、体型、重力变化下的高效迁移
第三类实验直接对应工业现场最头疼的问题:动力学变化。论文在 D4RL 环境中修改机器人的摩擦条件、腿部尺寸或重力,先在变化后的动力学上预训练 π₀,再只用少量原动力学数据适配新技能并组合。这类场景涵盖跨本体迁移、sim-to-real 与非平稳环境等现实需求。
结果显示:传统离线 RL 方法(BC、CQL、IQL、MOPO)在新动力学的小数据上表现糟糕;PSEC 不仅全面超过它们,还优于 DOGE 与 TSRL 等专为小样本设计的离线 RL 方法,以及把所有数据暴力混合训练的 Joint train 基线。这验证了 PSEC 的核心价值:从预训练策略中萃取可迁移知识,比“堆数据重训”更高效。
消融实验:LoRA 秩与上下文感知的稳健性
论文在持续策略漂移设定下对 LoRA 秩 n 做了系统消融:从 4 到 64 的所有秩设置下,PSEC 都稳定优于 MLP 变体,展现出对超参数的稳健性;其中 n = 8 效果最佳并被设为默认值——由于适配数据只有 10 条演示,秩过大反而会因为参数冗余而退化。这与低秩设计的初衷一致:用恰好足够的参数容量承接新技能,是有限数据下的最优折中。此外,上下文感知组合网络在各组合层级(参数级/噪声级/动作级)上都一致优于精心调整的固定组合权重,证明动态加权本身——而不只是组合层级——是性能的重要来源。
结语:让工业模型资产“自我校准、永续进化”
PSEC 的贡献在于把“技能”变成了可管理的参数资产:LoRA 模块化的技能库从机制上消除了灾难性遗忘,上下文感知的参数空间组合则让先验知识在新任务上被充分复用。在多目标组合、持续策略漂移与动力学漂移三类场景中,它都展现出显著优于现有方法的效率与性能。论文也坦诚其局限:预训练策略 π₀ 需要足够多样的分布才能保证 LoRA 微调的效果,这可以通过引入更广域的外部数据来缓解。
在工程落地层面,PSEC 是臻效智能模型资产全生命周期闭环的关键一环:新设备上线时,由无需前置建模的 ESC 算法通过微小受控扰动完成极速冷启动并沉淀高价值探索数据;长期运行中,工业表征模型与策略基于最新数据持续增量进化;整套机制由边缘侧操作系统(Zenfex AI-OS)在不干扰生产的前提下静默接管,自动完成模型增量微调与策略的平滑热更新——真正赋予工业实体资产“自我校准与永续进化”的能力。
论文作者:Tenglong Liu, Jianxiong Li, Yinan Zheng, Haoyi Niu, Yixing Lan, Xin Xu, Xianyuan Zhan(ICLR 2025)