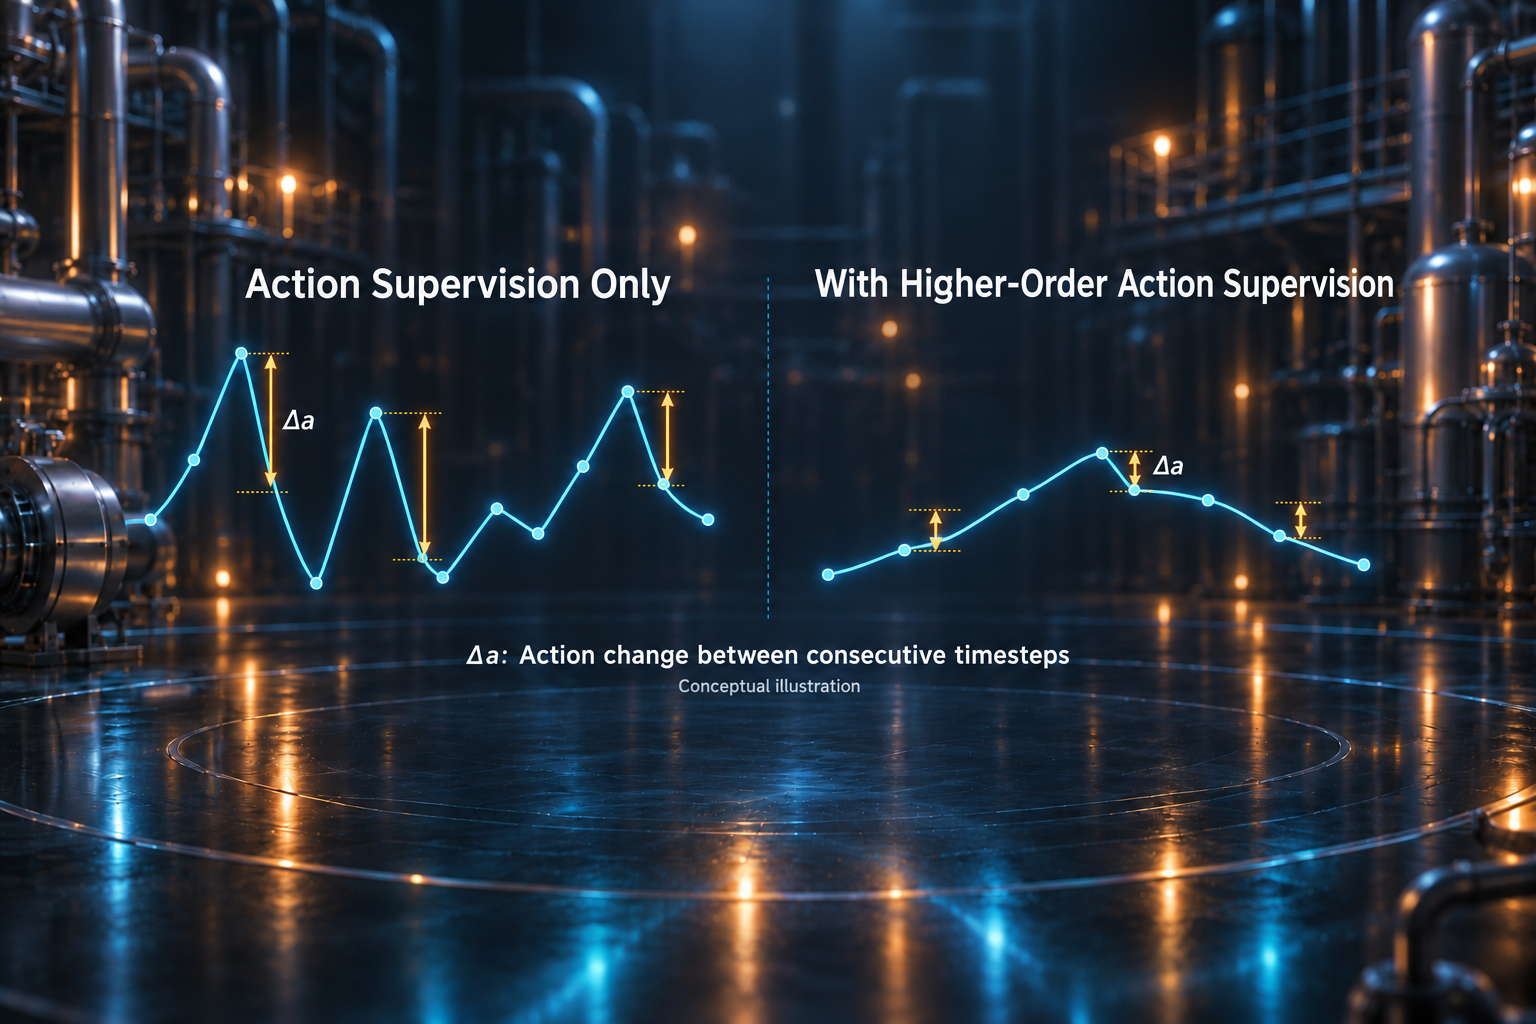
核心结论:复杂工业控制和具身智能任务都要求动作既选得准,也变得稳。相邻时刻的动作即使各自合理,连成轨迹后仍可能出现控制波动或机器人动作抖动。传统策略学习主要关注当前状态下应输出什么动作,对动作如何随状态变化的信息利用不足。这项获 NeurIPS 2026 录用的研究,将轨迹中的一阶动作变化转化为额外的监督信号。方法轻量、即插即用,无需更改原有策略网络架构,只需增加一项监督损失,即可适配确定性、高斯随机和流匹配等多种策略类型。实验表明,该方法在多个基准任务上大幅提升策略性能,在小样本场景中展现出更强的泛化能力,同时使动作变化更平滑、控制表现更稳定。
问题背景:为什么要额外监督动作变化
许多模仿学习和离线强化学习方法主要拟合单步动作:给定状态 s,预测动作 a。连续控制不仅要看每一步动作是否合理,还要看前后动作能否平稳衔接。复杂工业场景中的控制、机器人关节力矩、车辆转向角和无人机推力都需要随时间不断调整;如果相邻时刻的控制量变化过于剧烈,即使单步动作看似合理,整体轨迹也可能偏离目标,并增加能耗或机械负担。
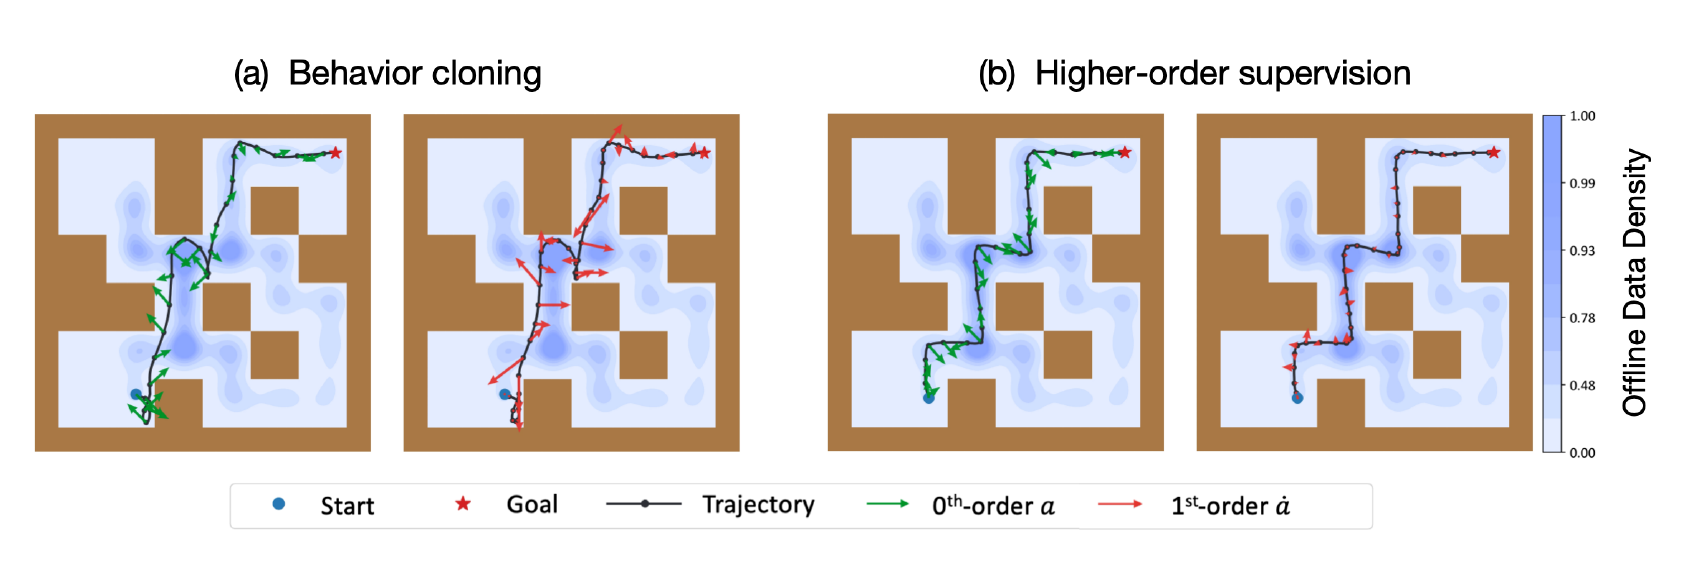
论文中的迷宫任务直观展示了这个问题:只拟合动作标签的行为克隆,其动作变化方向频繁摆动,路径也随之偏离;加入一阶动作监督后,动作及其变化方向更连贯,智能体沿更稳定的路径抵达目标。
核心方法:在原有策略上加入动作变化约束
一种最简单直接的解决思路,是让策略网络同时预测动作及其变化率,但这需要增加输出分支,并在训练中兼顾两个目标。论文选择了更简洁的做法:保留原有网络结构,只在训练损失中加入对动作变化的约束。
具体而言,对于离线轨迹中的连续样本(s,a,s′,a′),作者以单位时间间隔近似,将状态变化量与动作变化量分别写为ṡ=s′−s 和ȧ=a′−a。再对策略π(s)沿真实轨迹的时间求导,利用链式法则得到下面的关系:
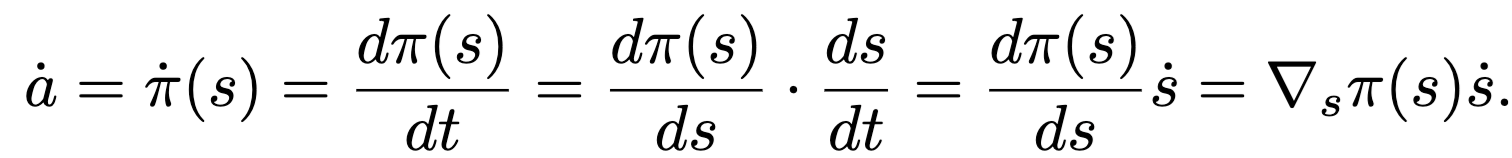
训练时,让策略预测的动作变化率接近相邻样本之间的实际动作差。对于确定性行为克隆,这相当于在原有动作拟合损失上增加一项平方误差。
极轻量级引入三类策略
确定性策略
对确定性策略,原有行为克隆损失继续约束预测动作π(s)接近数据动作a;新增的一阶损失则约束策略在状态变化方向上的导数,使其接近观测到的动作差。TD3+BC等方法因此可以沿用原有网络,只需调整训练目标。
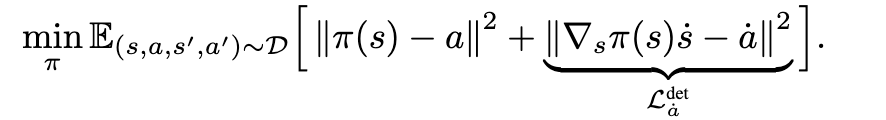
高斯随机策略
随机策略还需考虑动作分布的方差。简化方案仅监督高斯均值μ(s)随状态的变化;完整方案将随机项建模为Ornstein–Uhlenbeck(OU)过程,得到一阶动作的演化方程。训练时同时优化原始动作与一阶动作的似然,使模型兼顾分布拟合和动作随时间的变化。
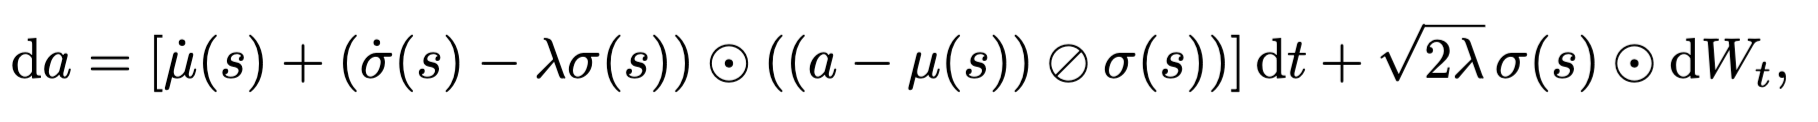
流匹配策略
流匹配策略涉及两种时间:将噪声逐步变成动作的生成时间k,以及真实控制轨迹的物理时间。标准流匹配主要学习前者。论文进一步约束速度场对状态变化的响应,使生成动作随物理时间的变化与轨迹中的一阶动作信息相匹配。
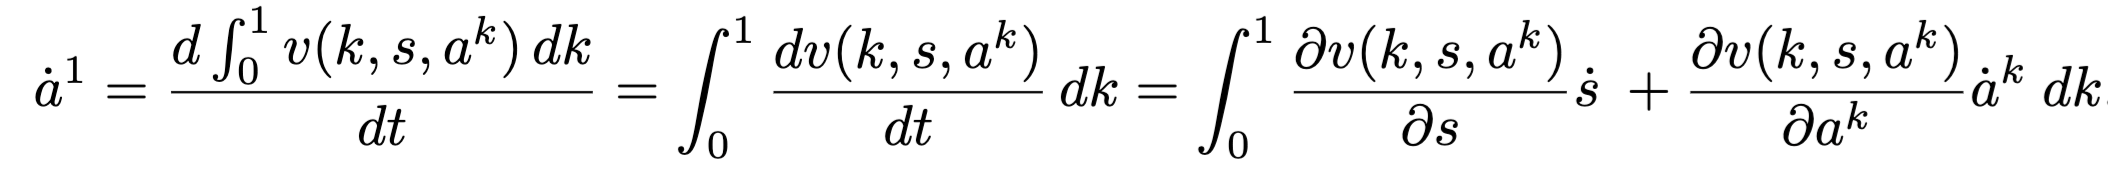
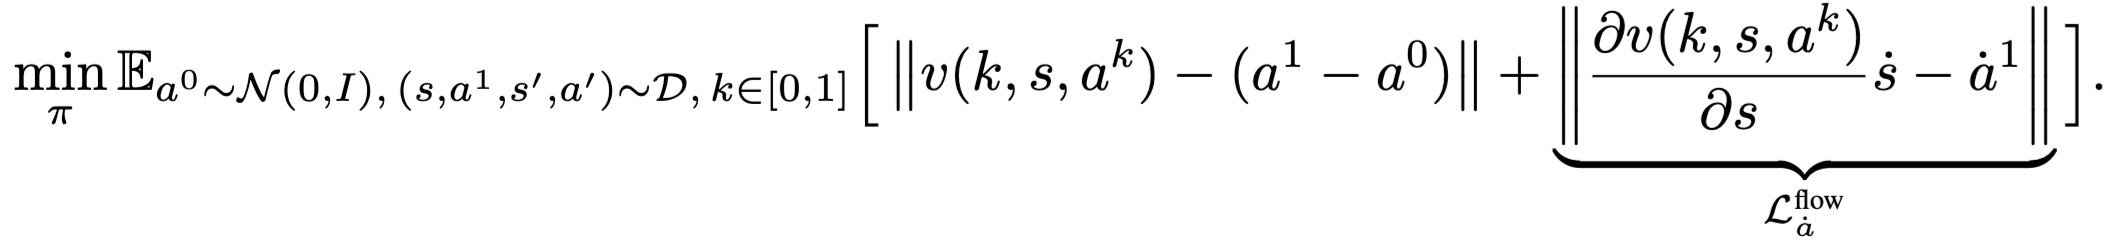
从模仿学习扩展到离线强化学习
在模仿学习中,一阶动作差可直接作为额外监督。离线强化学习还需估计长期回报,因此论文借助连续时间Hamilton–Jacobi–Bellman(HJB)框架:Q函数表示沿连续轨迹积累的折扣回报,γ决定折扣随时间衰减的速度。
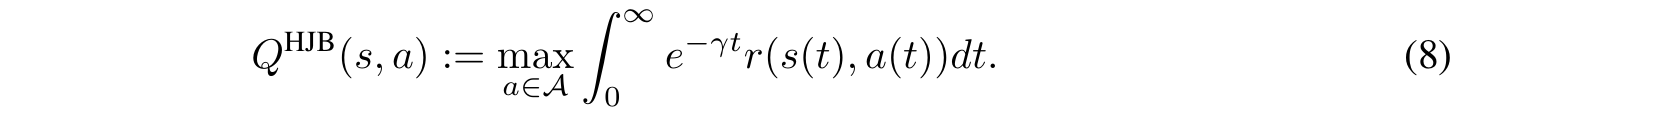
HJB方程把长期回报拆解为局部量:即时奖励r(s,a),以及Q随状态和动作变化的两项方向导数。式9中的∇sQ⋅ṡ对应状态变化,∇aQ⋅ȧ对应动作变化。
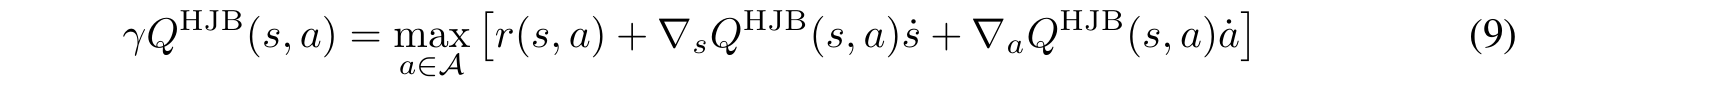
常规离线强化学习通常通过Bellman目标更新价值函数Q(s,a)。加入一阶动作监督后,策略可估计动作随状态变化的方向π̇θ(s),为HJB方程中的动作方向项提供信号。
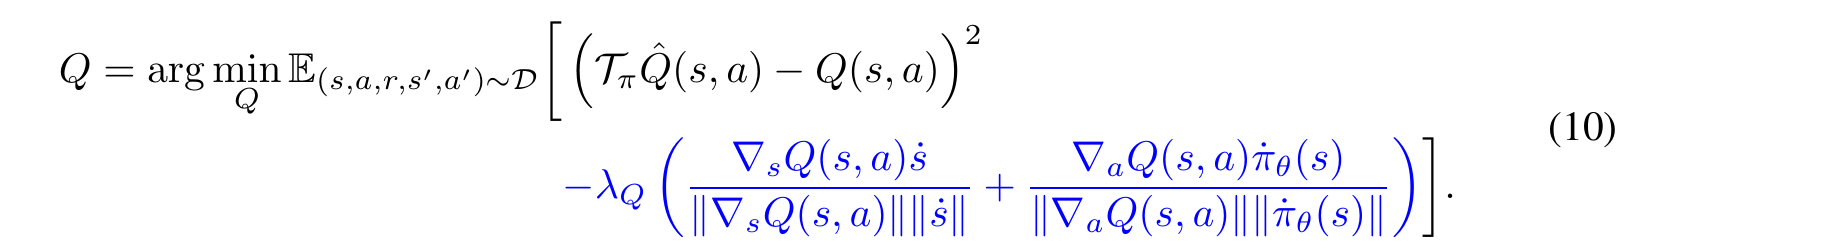
式10在原有Bellman平方残差之外,加入两项方向对齐约束:一项使价值函数的状态梯度∇sQ与轨迹中的状态变化ṡ=s′−s同向;另一项使动作梯度∇aQ与策略预测的动作变化π̇θ(s)同向。
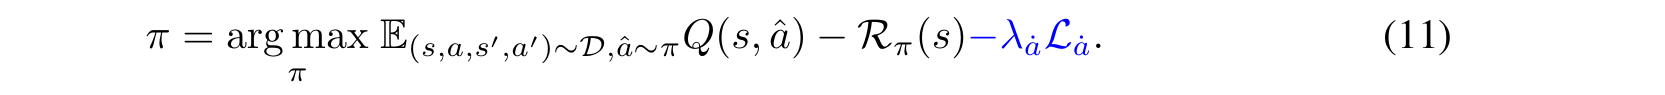
式11将一阶动作监督损失Lȧ加入策略优化目标。方法保留各算法原有的回报优化和行为约束,仅对损失函数做调整。作者据此扩展TD3+BC、ReBRAC、IQL和IFQL,并沿用各自原有的策略网络。
OGBench和D4RL上的实验结果
作者在OGBench和D4RL两个基准上评估了该方法。OGBench涵盖10类、共50个基于状态的任务,包括长时序导航、物体交互和机器人操作;状态维度为28至83,动作维度为5至21。D4RL实验选取Hopper、HalfCheetah和Walker2d,每个任务使用约1万条转移构成小数据集,并保留计算相邻状态差和动作差所需的时间顺序。主要结果均汇总自5个随机种子。
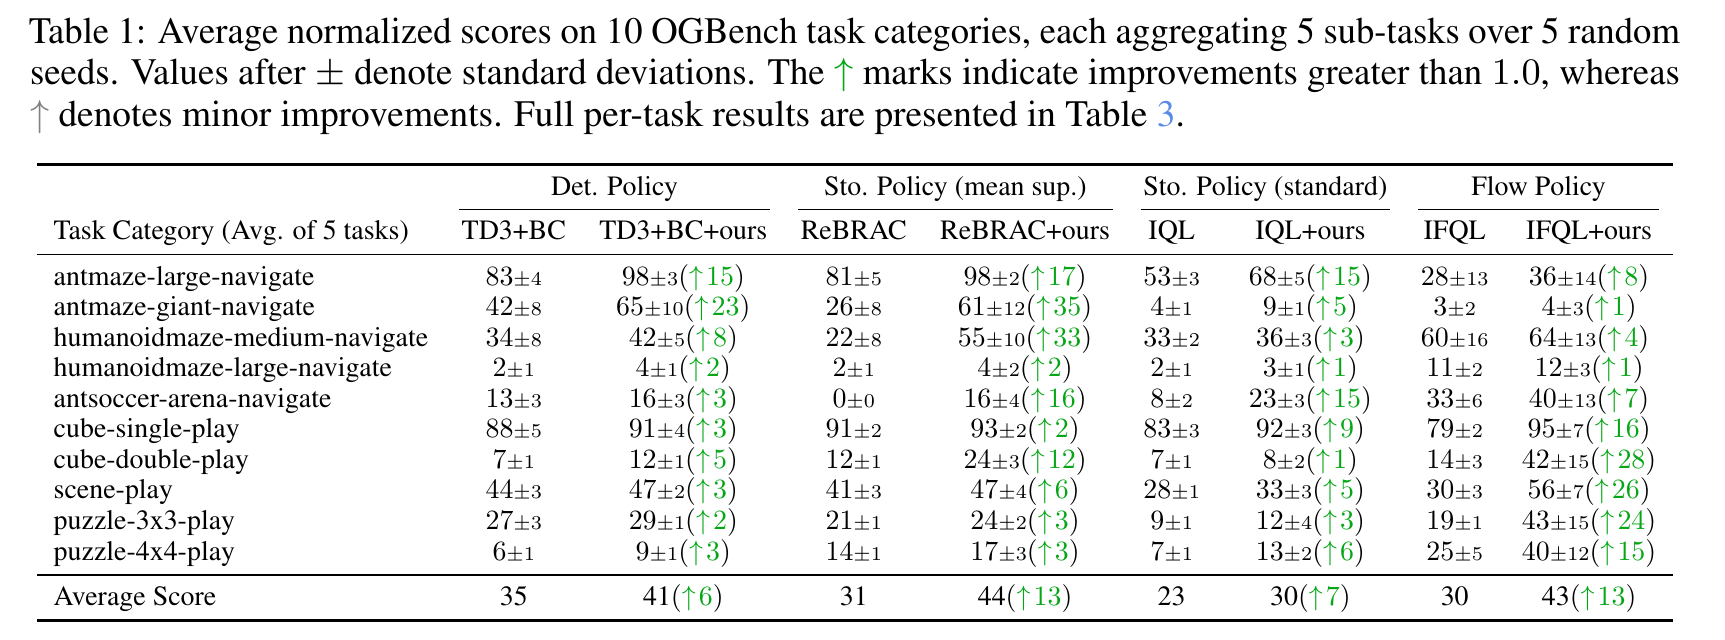
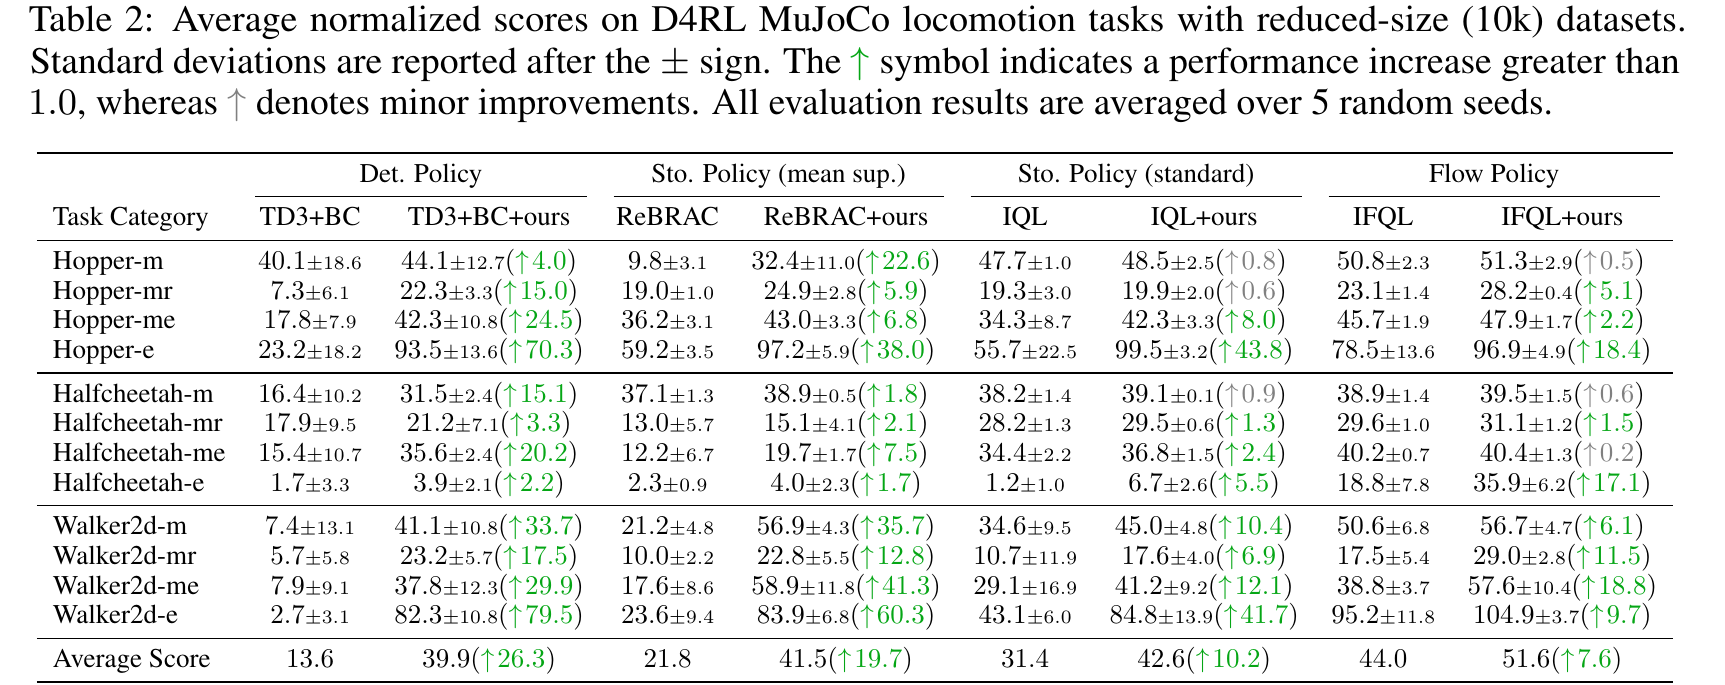
平均分之外,部分较难任务的变化也值得注意。在OGBench上,ReBRAC在antmaze-giant-navigate类别的平均分从26升至61,在humanoidmaze-medium-navigate从22升至55;IFQL在cube-double-play从14升至42,在scene-play从30升至56。细分到单项任务,scene-play-singletask-task2上的IFQL基线得分为0,加入一阶监督后为88。
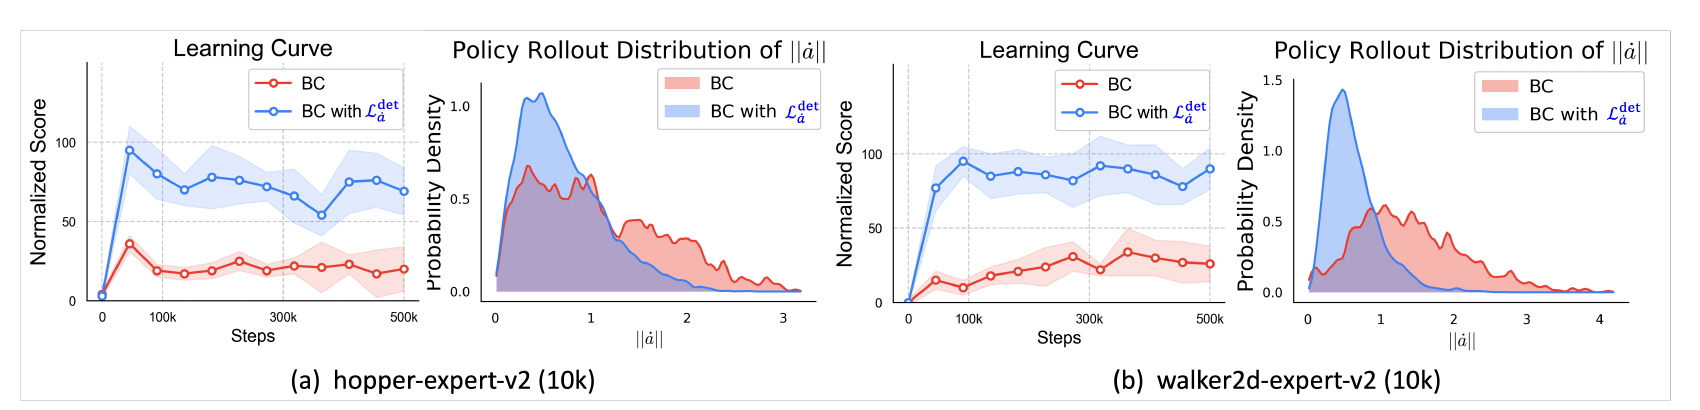
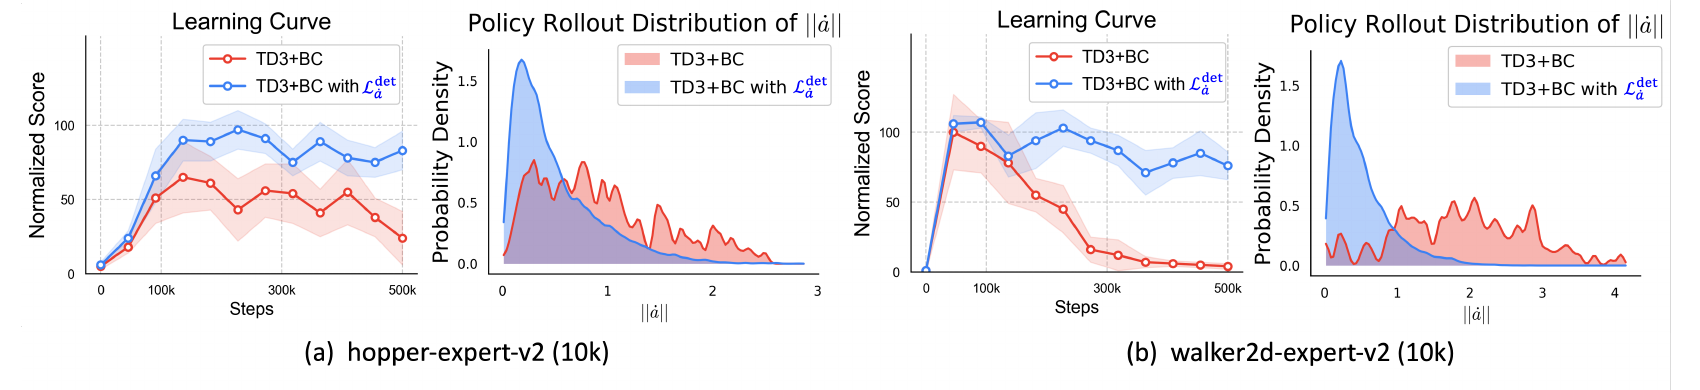
小数据D4RL实验中,walker2d-expert上的TD3+BC得分由2.7升至82.3,hopper-expert上的IQL由55.7升至99.5。即使不使用奖励信号、仅做确定性行为克隆,Walker2d-expert得分也从26.7升至91.1。这些结果表明,连续轨迹中的局部变化信息在样本较少时能够提供有用的训练信号。
训练曲线和动作变化
论文还比较了行为克隆和TD3+BC在10k数据设置下的学习曲线,以及策略执行轨迹中的动作差范数分布。在图中展示的任务上,加入一阶监督后的得分曲线总体更高,动作差也更集中在较小区间,说明策略输出较少出现大幅跳变。得分曲线和阴影基于5个随机种子;动作差分布由10条执行轨迹汇总。
消融实验:策略端和价值端的贡献
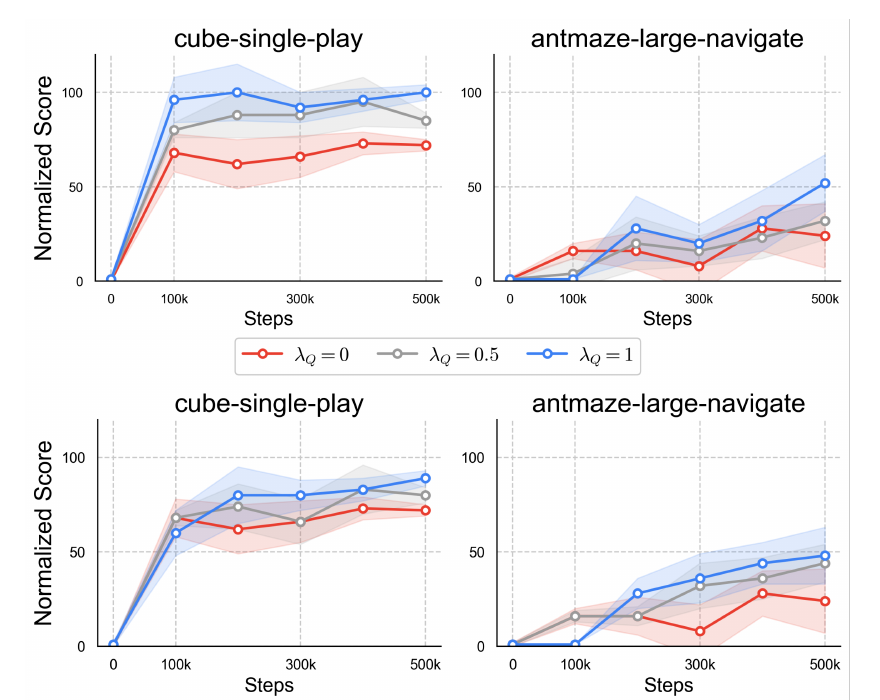
离线强化学习中的改动有两处:策略端加入一阶动作监督,价值端加入沿局部状态与动作变化方向的一致性约束。消融实验分别改变两项权重。IFQL在cube-single-play和antmaze-large-navigate上的结果显示,两项约束都能带来增益;附录中TD3+BC和IQL的结果也呈类似趋势。
结语:轻量、即插即用的高阶动作监督
本研究将连续轨迹中的一阶动作变化转化为高阶监督信号,无需改动原有策略架构,仅增加一项损失即可适配确定性、高斯随机和流匹配等多种策略。实验显示,该方法在 OGBench 上提升了整体性能,在仅使用约 1% 数据的 D4RL 场景中仍显著改善小样本表现,同时使动作变化更平滑,为复杂工业控制和具身智能提供了轻量、即插即用的策略优化思路。