核心结论:论文提出 FISOR(FeasIbility-guided Safe Offline RL),首次在离线设定下实现状态级零违规的安全硬约束:通过离线 HJ 可达性分析从数据中识别最大可行域,将"安全约束满足、回报最大化、行为正则"这一高度耦合的三元问题转化为可行性依赖目标,并证明其最优策略具有分区加权行为克隆的闭式形式,可用无需时变分类器的能量引导扩散模型稳定提取。在安全离线 RL 标准基准 DSRL 的 26 个任务上,FISOR 是唯一在全部任务中安全达标的算法,同时在多数任务取得最高归一化回报。
问题背景:安全离线强化学习的"三元耦合"困境
在工业控制、自动驾驶等安全攸关的决策任务中,任何一次不安全行为的后果都可能是不可逆的。安全强化学习把这类问题建模为约束马尔可夫决策过程(CMDP),但在线安全 RL 在训练与部署阶段都要与真实系统反复试错交互,在缺乏高保真仿真器的场景中风险极高。安全离线强化学习提供了一条更务实的路线:只从离线的历史数据集(其中同时包含安全与不安全的轨迹)中学习策略,只需保证最终学到的策略安全,从而绕开在线训练的固有风险。
然而,现有的安全离线 RL 方法几乎全部建立在软约束之上——只要求期望意义上的累计成本不超过预设的成本上限(cost limit)l。这一范式存在三重缺陷:
- 期望约束不等于安全:软约束只对整条轨迹的期望违规量做限制,只要 l 大于零,策略就始终存在正的违规概率。这在学术界被广泛接受,但对安全攸关的工业应用是不可接受的——真正需要的是状态级零违规的硬约束。
- 成本上限超参难以选择:能让安全性能最优的成本上限 l 因任务而异,选出一个合适的值严重依赖工程经验,往往需要逐任务反复调试。
- 三目标耦合导致训练不稳定:安全离线 RL 需要同时优化三个互相冲突的目标——最大化回报、满足安全约束、以及贴近行为策略以对抗离线设定下的分布偏移。常用的拉格朗日对偶解法还要额外引入一层乘子优化,回报价值函数、成本价值函数与策略的学习互相纠缠,微小的近似误差会在三者之间自举放大,造成严重的训练不稳定。
一个直觉的替代方案是直接把软约束换成硬约束:去掉期望号、把成本上限置零,即要求 Vc(s) ≤ 0。但这条"朴素硬约束"路线在离线设定下几乎不可行:成本价值 Vc 本身非负,在神经网络近似误差下精确取到 0 极为困难,导致可行策略集被压缩得过窄、策略极度保守;更重要的是,并非所有状态都存在满足硬约束的策略——对这些不可行状态,问题根本无解。如何在离线设定下既施加硬约束、又不让策略集坍塌,正是这篇论文要解决的核心问题。
核心方法:把硬约束翻译成"最大可行域识别"
论文的关键洞察是:借助安全控制理论中的哈密顿-雅可比(HJ)可达性分析,硬约束可以等价地转化为在离线数据集上识别最大可行域。由此,原本纠缠在一起的三元问题被拆解为三个完全解耦、各自独立的学习过程:离线可行性识别、最优优势函数学习、引导扩散策略提取。这就是 FISOR(FeasIbility-guided Safe Offline RL)。
第一步:离线 HJ 可达性分析,从数据中划出最大可行域
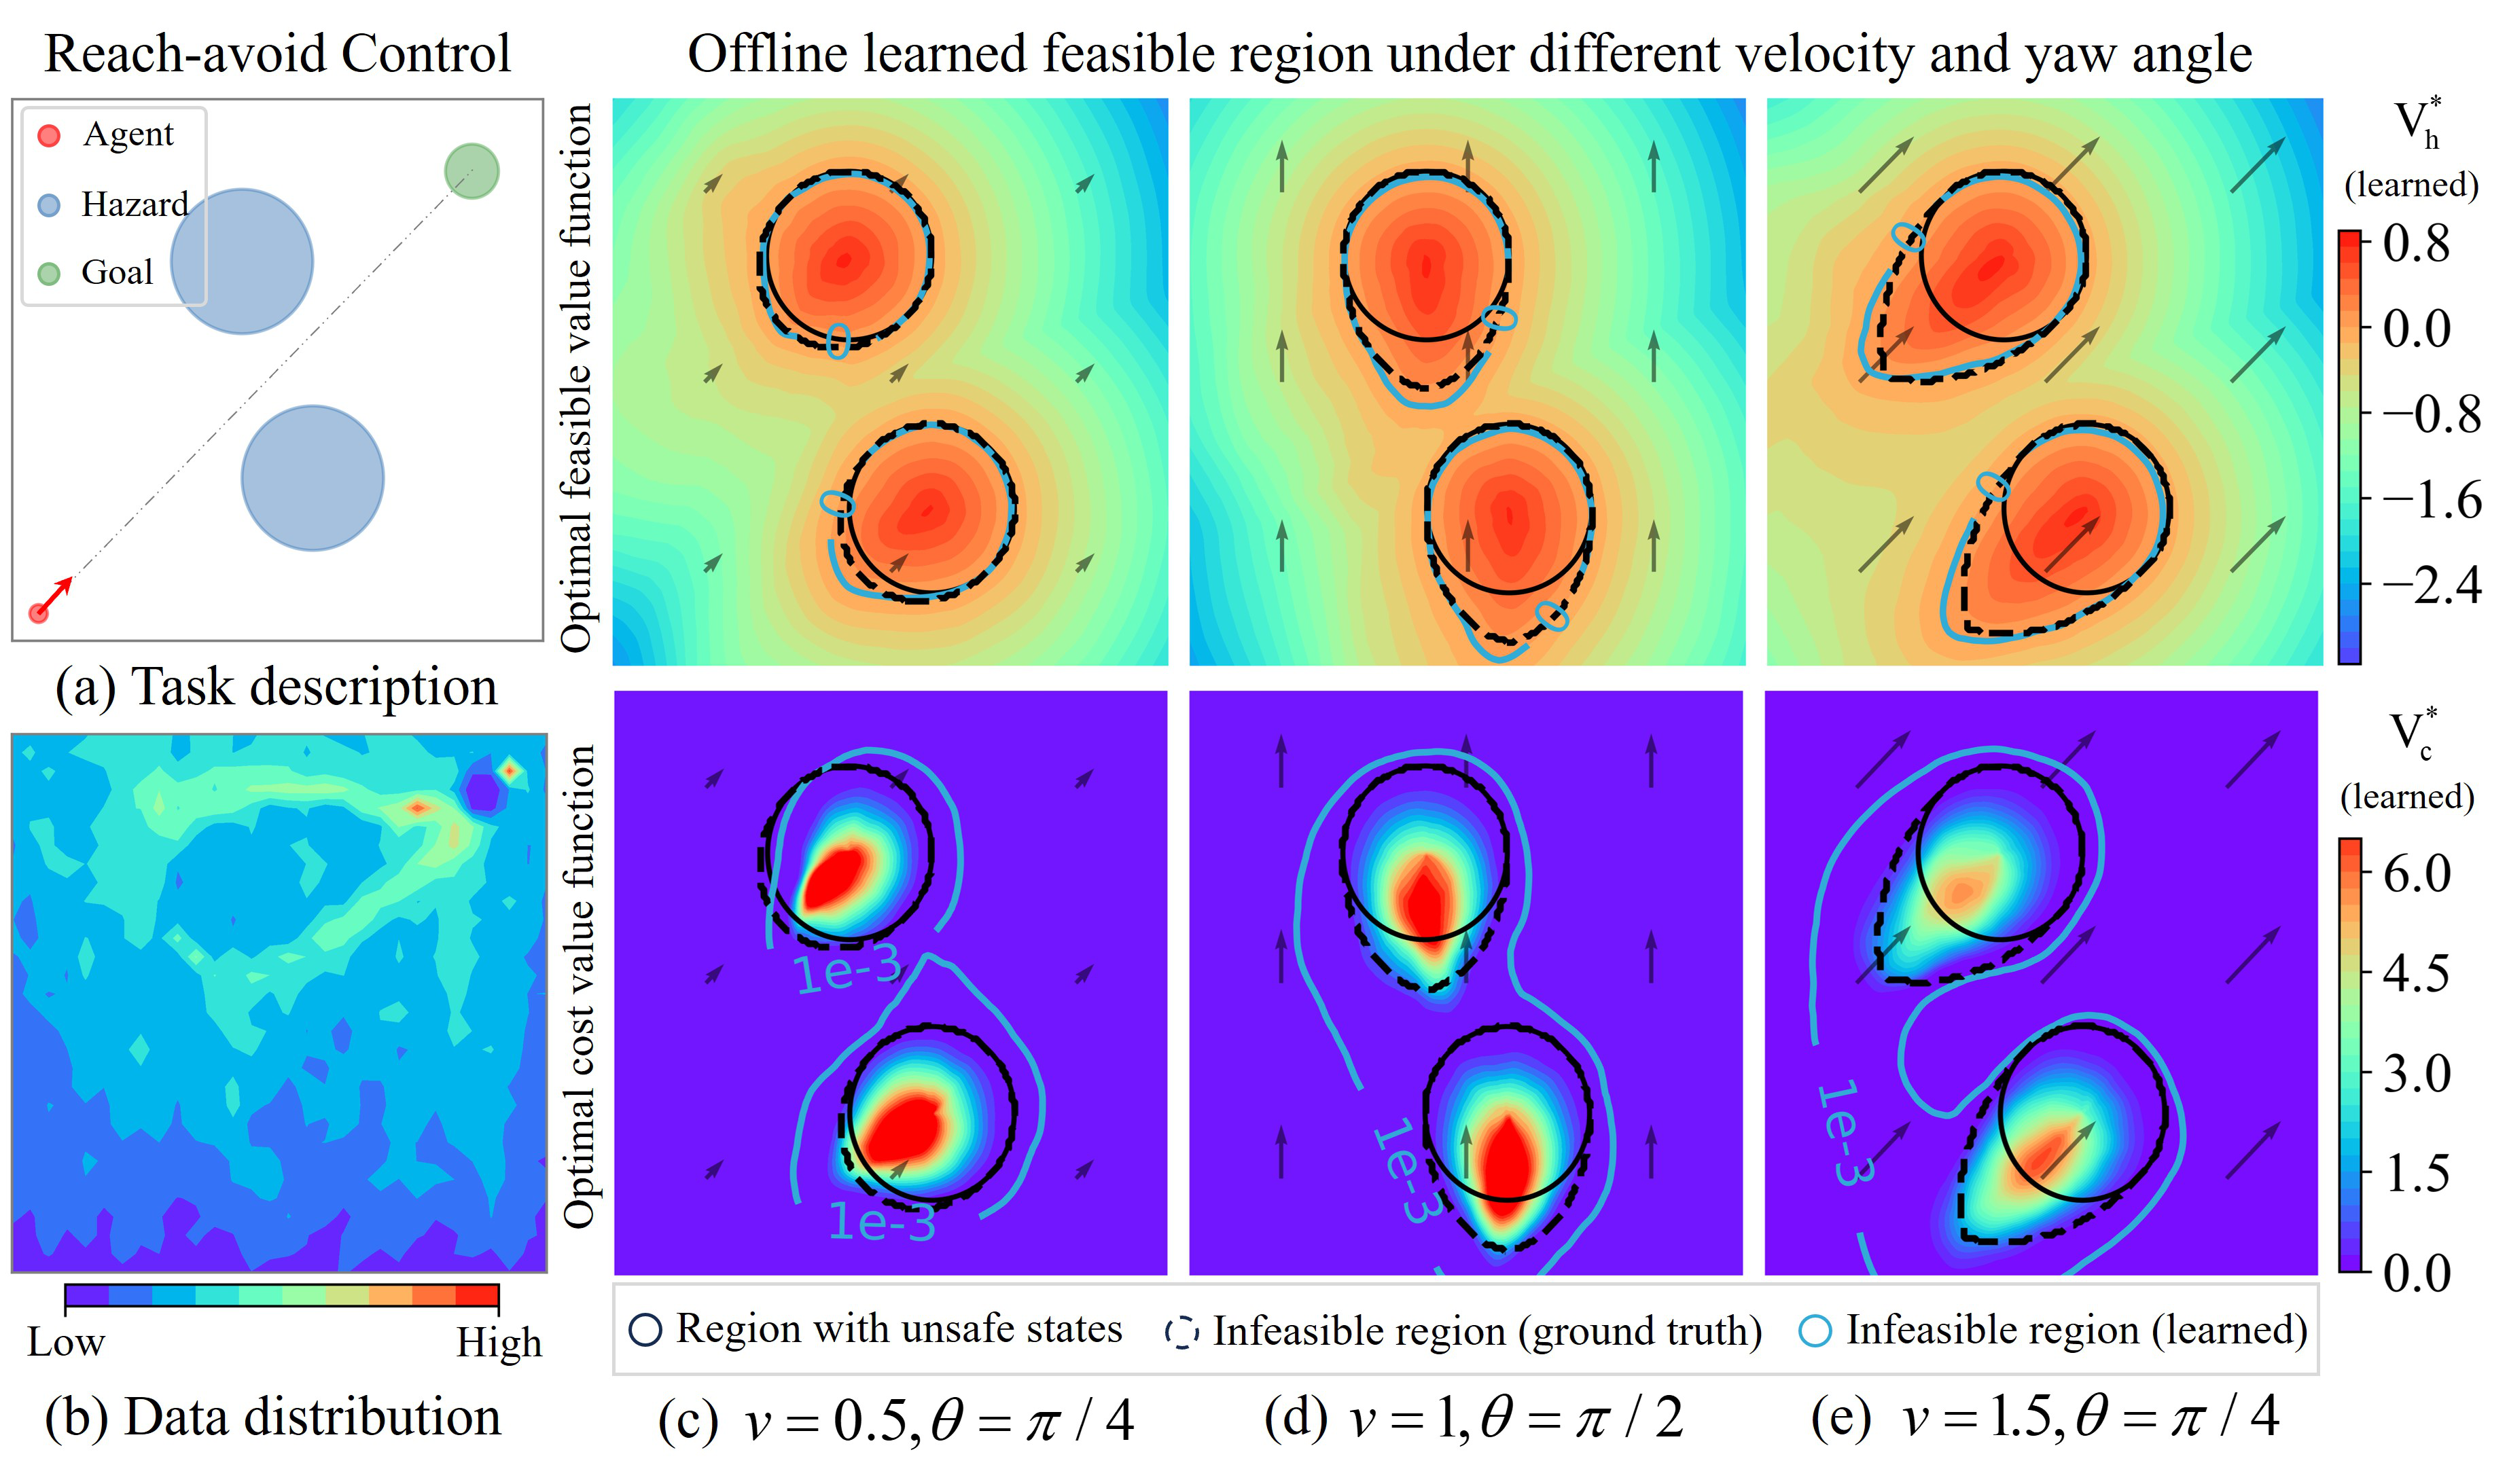
HJ 可达性定义了最优可行值函数 V*h(s):从状态 s 出发、在最安全的策略下整条轨迹上约束违规函数 h 的最大值。它天然地刻画了状态的可行性——V*h(s) ≤ 0 意味着存在至少一个策略能从 s 出发满足硬约束,V*h(s) > 0 则意味着任何策略都必然违规。于是最大可行域可以定义为 S*f = {s | V*h(s) ≤ 0},即可行策略非空的所有状态的集合。与取值非负的成本价值 Vc 不同,Vh 取值于整个实数域,因此更适合作为可实际求解的硬约束。
传统 HJ 可达性需要与环境交互做蒙特卡洛估计,离线设定下不可用。论文借鉴近似动态规划,通过反复施加带折扣因子 γ→1 的可行贝尔曼算子来逼近 V*h;而算子中对下一状态动作的 min 操作会查询分布外动作、在离线设定下引发严重低估,论文受 IQL 启发,采用反向 expectile 回归(reversed expectile regression):用非对称损失 Lrevτ(u) = |τ − I(u > 0)|u²(τ ∈ (0.5, 1))压低大于 Vh 的 Qh 值的影响、强调更小的取值,从而无需显式建模行为策略,就能仅在数据支撑集上估计最小可行值。两个纯监督损失交替优化,即可预先划定近似的最大可行域。
第二步:可行性依赖的优化目标,安全与回报各归其位
有了最大可行域 S*f,论文把优化问题按状态可行性拆成两半:在可行域内,硬约束由可行策略集自动保证,策略只需专注于最大化回报;在不可行域内,违规已不可避免,最大化回报失去意义,目标转为尽可能最小化未来的约束违规(即尽快"逃回"安全区域)。论文进一步用 Lemma 1 证明:这两个目标与可行域内的安全约束可以完全解耦——先在数据上学好最优回报优势 A*r 与最优可行优势 A*h,再各自独立地优化策略,安全约束直接用预先学好的 Q*h 施加,无需与其他网络耦合训练。
基于这一解耦目标,Theorem 1 给出最优策略的闭式解:π*(a|s) ∝ πβ(a|s) · w(s, a),即一种分区加权行为克隆——在可行域内权重为 exp(α₁A*r(s, a)) · I{Q*h(s, a) ≤ 0}(偏好高回报且保持可行的动作),在不可行域内权重为 exp(−α₂A*h(s, a))(偏好违规最小的动作),α₁、α₂ 为控制行为正则强度的温度系数。这一形式让最优策略的提取异常简单而稳定,同时天然地在安全保障、回报最大化与行为正则之间取得平衡。
第三步:无需时变分类器的能量引导扩散策略
最优策略需要根据状态可行性采取截然不同的行为模式,分布形态复杂,论文选用表达能力强的扩散模型来参数化策略。常规做法是训练一个额外的时变分类器(time-dependent classifier)来引导扩散采样,但这类分类器训练困难、会引入额外误差。Theorem 2 证明了加权回归与精确能量引导之间的内在等价性:只需在行为策略的标准扩散训练损失上乘以权重函数 w(s, a),得到的加权回归损失就精确等价于对目标分布 π* 的能量引导采样,完全绕开了时变分类器的训练。实践中,最优回报优势 A*r 用 IQL 以样本内(in-sample)方式学习,无需显式策略、训练稳定;推理时再从扩散策略采样 N 个候选动作、选取 Q*h 最低(最安全)的一个输出,进一步增强安全性。至此,原问题被转化为三个独立的监督学习目标,训练稳定性远超耦合式解法。
DSRL 基准主实验:26 个任务中唯一全部安全达标
论文在安全离线 RL 标准基准 DSRL 上做了大规模评测,覆盖 Safety-Gymnasium、Bullet-Safety-Gym 与 MetaDrive 三类环境共 26 个任务。为模拟安全攸关场景,评测采用了比基准默认更严格的安全要求:较难的 Safety-Gymnasium 成本上限设为 10,其余环境设为 5;采用归一化回报与归一化成本作为指标,归一化成本 ≤ 1 视为安全达标,每个数值均为 20 个评估回合 × 3 个随机种子的平均。对比基线包括 BC、CDT、BCQ-Lag、CPQ、COptiDICE 与基于扩散分类器引导的 TREBI。
以 Safety-Gymnasium 的 CarButton1 任务为例(归一化回报越高越好,归一化成本越低越好、需 ≤ 1):
| 方法 | CarButton1 回报 ↑ | CarButton1 成本 ↓(≤1 为安全) |
|---|---|---|
| BC | 0.01 | 6.19 |
| CDT | 0.17 | 7.05 |
| BCQ-Lag | 0.13 | 6.68 |
| CPQ | 0.22 | 40.06 |
| COptiDICE | -0.16 | 4.63 |
| TREBI | 0.07 | 3.75 |
| FISOR | -0.02 | 0.26 |
可以看到,所有软约束基线在该任务上的成本都数倍于安全阈值,唯有 FISOR 以 0.26 的成本达标。这一格局贯穿整个基准:FISOR 是唯一在全部 26 个任务上安全达标的算法,同时在多数任务上取得最高回报。例如在 CarPush1 上,FISOR 取得 0.28 的回报与 0.28 的成本——是所有安全算法中的最高回报;在 CarGoal1 上为 0.49/0.83,同样是安全算法中回报最高。按环境族平均:Safety-Gymnasium 上 FISOR 平均回报/成本为 0.30/0.35(最优基线 TREBI 为 0.28/1.36,仍超标),Bullet-Gym 上为 0.39/0.10(最优基线平均成本 2.09),MetaDrive 上为 0.36/0.25(最优基线 CDT 为 0.25/1.45)。其他方法则各有硬伤:BCQ-Lag 的拉格朗日耦合训练不稳定、难以兼顾安全与回报;CPQ 过于保守,约束收紧时回报骤降;CDT 与 TREBI 架构复杂,在部分任务上能达标但软约束的本质使其整体安全表现不佳。论文附录还报告了把安全在线 RL 方法(Sauté、RCRL)改造到离线设定的实验:即使精心调参,这些方法仍因目标耦合与分布偏移而表现远逊于 FISOR。
免调参稳定性验证:一组超参通吃 26 个任务
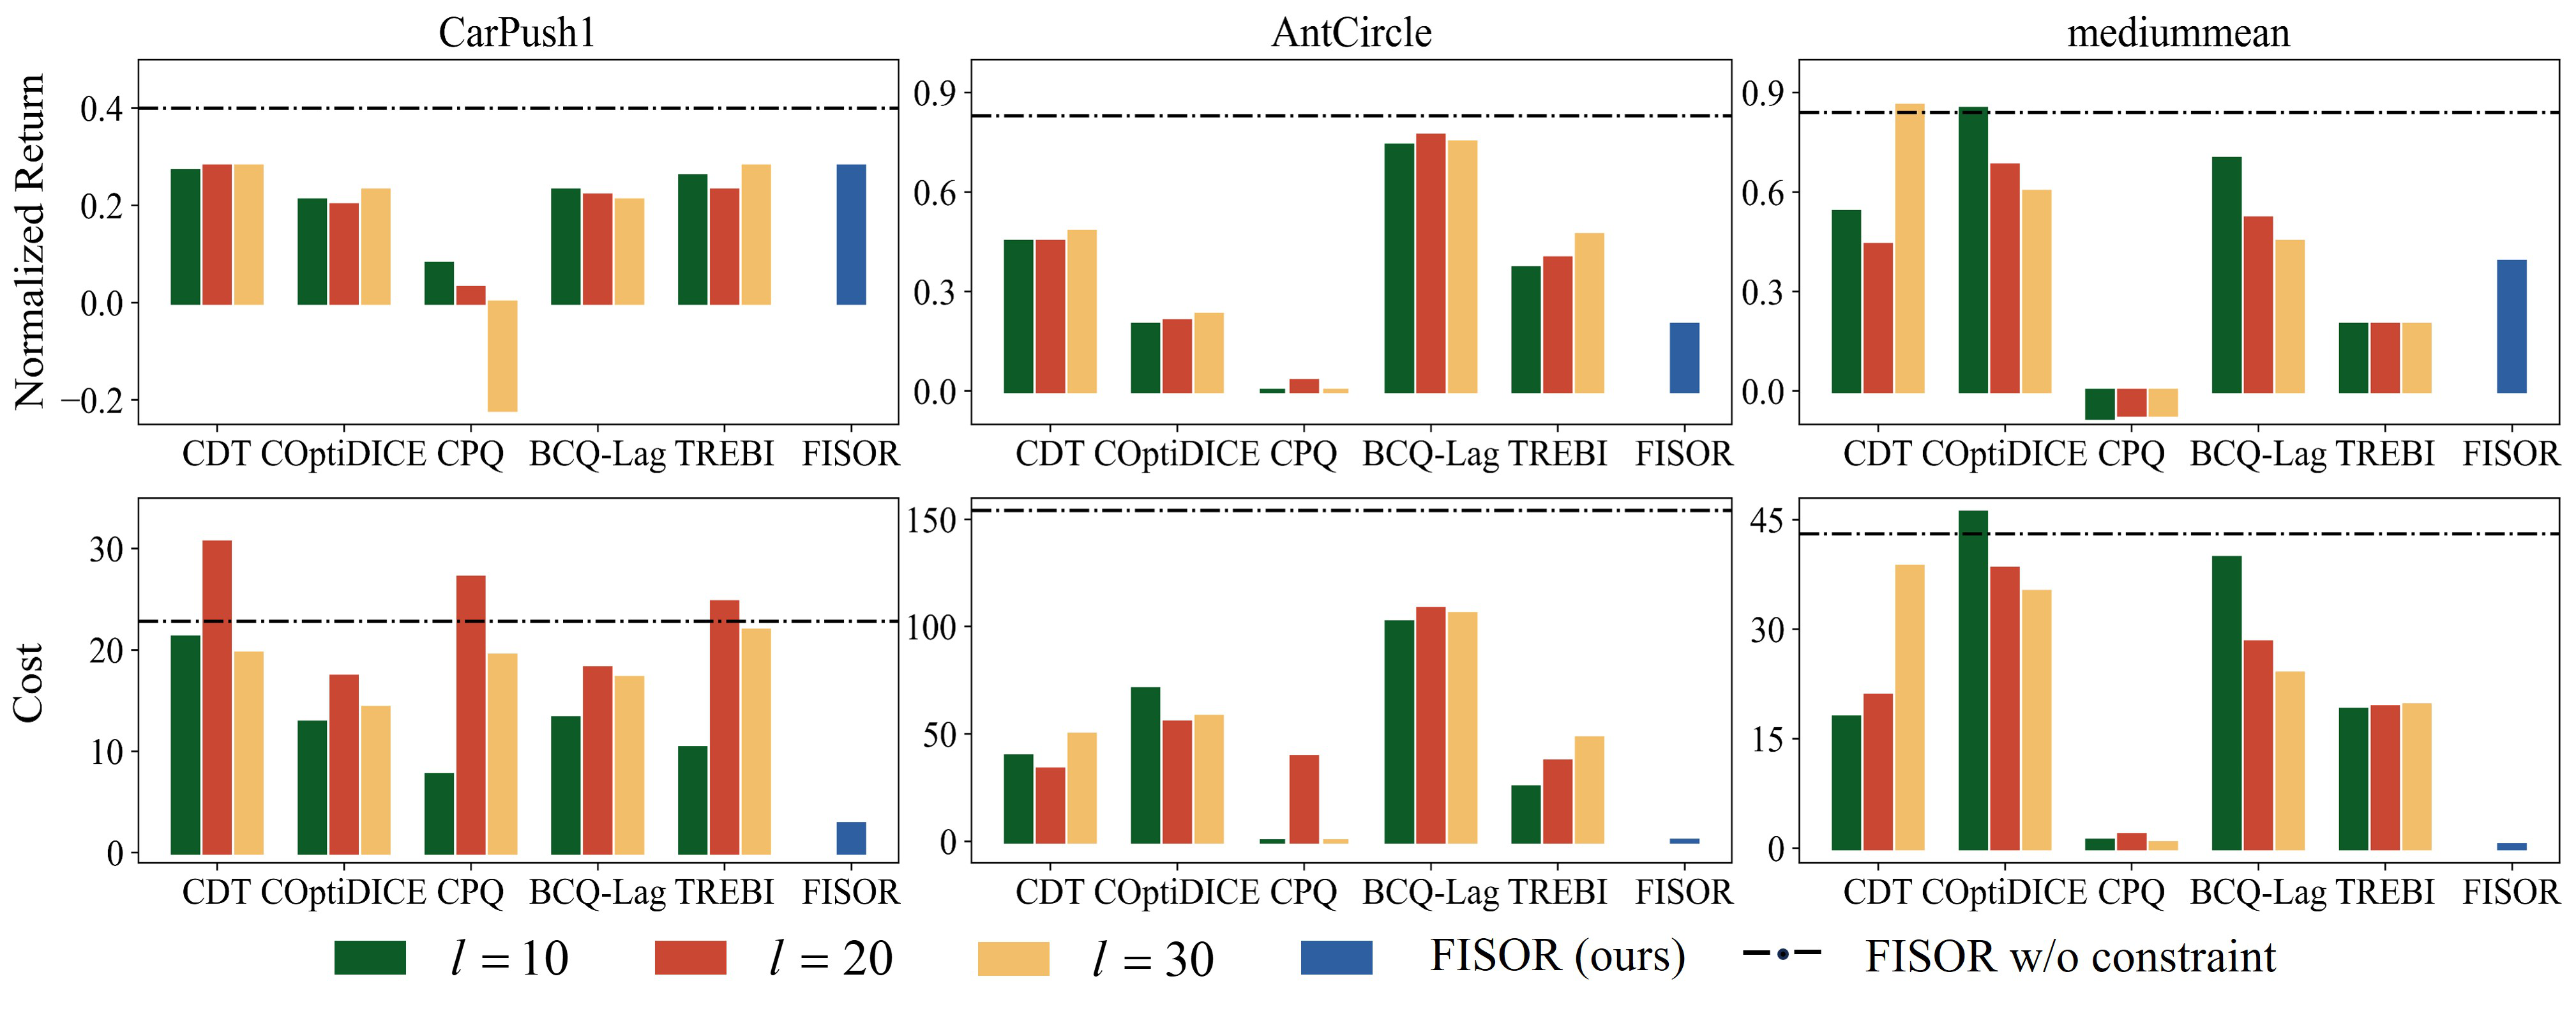
软约束方法的一个隐性成本是:每个任务都要重新挑选成本上限 l。论文在三个环境上对 l 做了敏感性扫描,结果显示大多数软约束方法对 l 的取值高度敏感——在某些情况下,选择更小的成本上限反而导致最终成本不降反升。这意味着软约束方法很难靠选对一个 l 来获得最佳性能,必须逐任务调参。而采用硬约束的 FISOR 根本不存在这个问题。
论文还扫描了 FISOR 自身的两个关键超参:expectile 参数 τ 与评估时采样的候选动作数 N。结果表明,τ 与 N 主要影响策略的保守程度——更大的 τ 与更小的 N 对应更激进的策略,反之则更保守——但对安全达标没有显著影响。最终论文固定 τ = 0.9、N = 16 这一组超参,在全部 26 个任务上一律使用,不做任何逐任务调整。此外,附录的数据量敏感性实验显示,在只剩原始 1/10 数据的小数据设定下,所有基线全部崩溃,FISOR 仍是唯一满足安全要求的方法——论文将这种稳定性归因于三个学习目标解耦带来的训练稳健性。
扩展实验:安全离线模仿学习
FISOR 的框架还天然适用于安全离线模仿学习(IL)设定:数据集中只有同时包含安全与不安全行为的高回报专家轨迹、且没有奖励标签,目标是学到既像专家又安全的策略。此时只需把权重函数略作修改——可行域内的权重从 exp(α₁A*r) 换成可行动作指示 I{Q*h(s, a) ≤ 0},不可行域内保持不变。论文在 MetaDrive 的 mediumsparse、mediummean、mediumdense 三个环境上,从 DSRL 数据集中筛出回报大于 220 的轨迹(其中同时包含安全与不安全轨迹)构成专家数据集,与 BC、带固定安全惩罚的 BC-P、以及带 PID 拉格朗日乘子的 BC-L 对比。
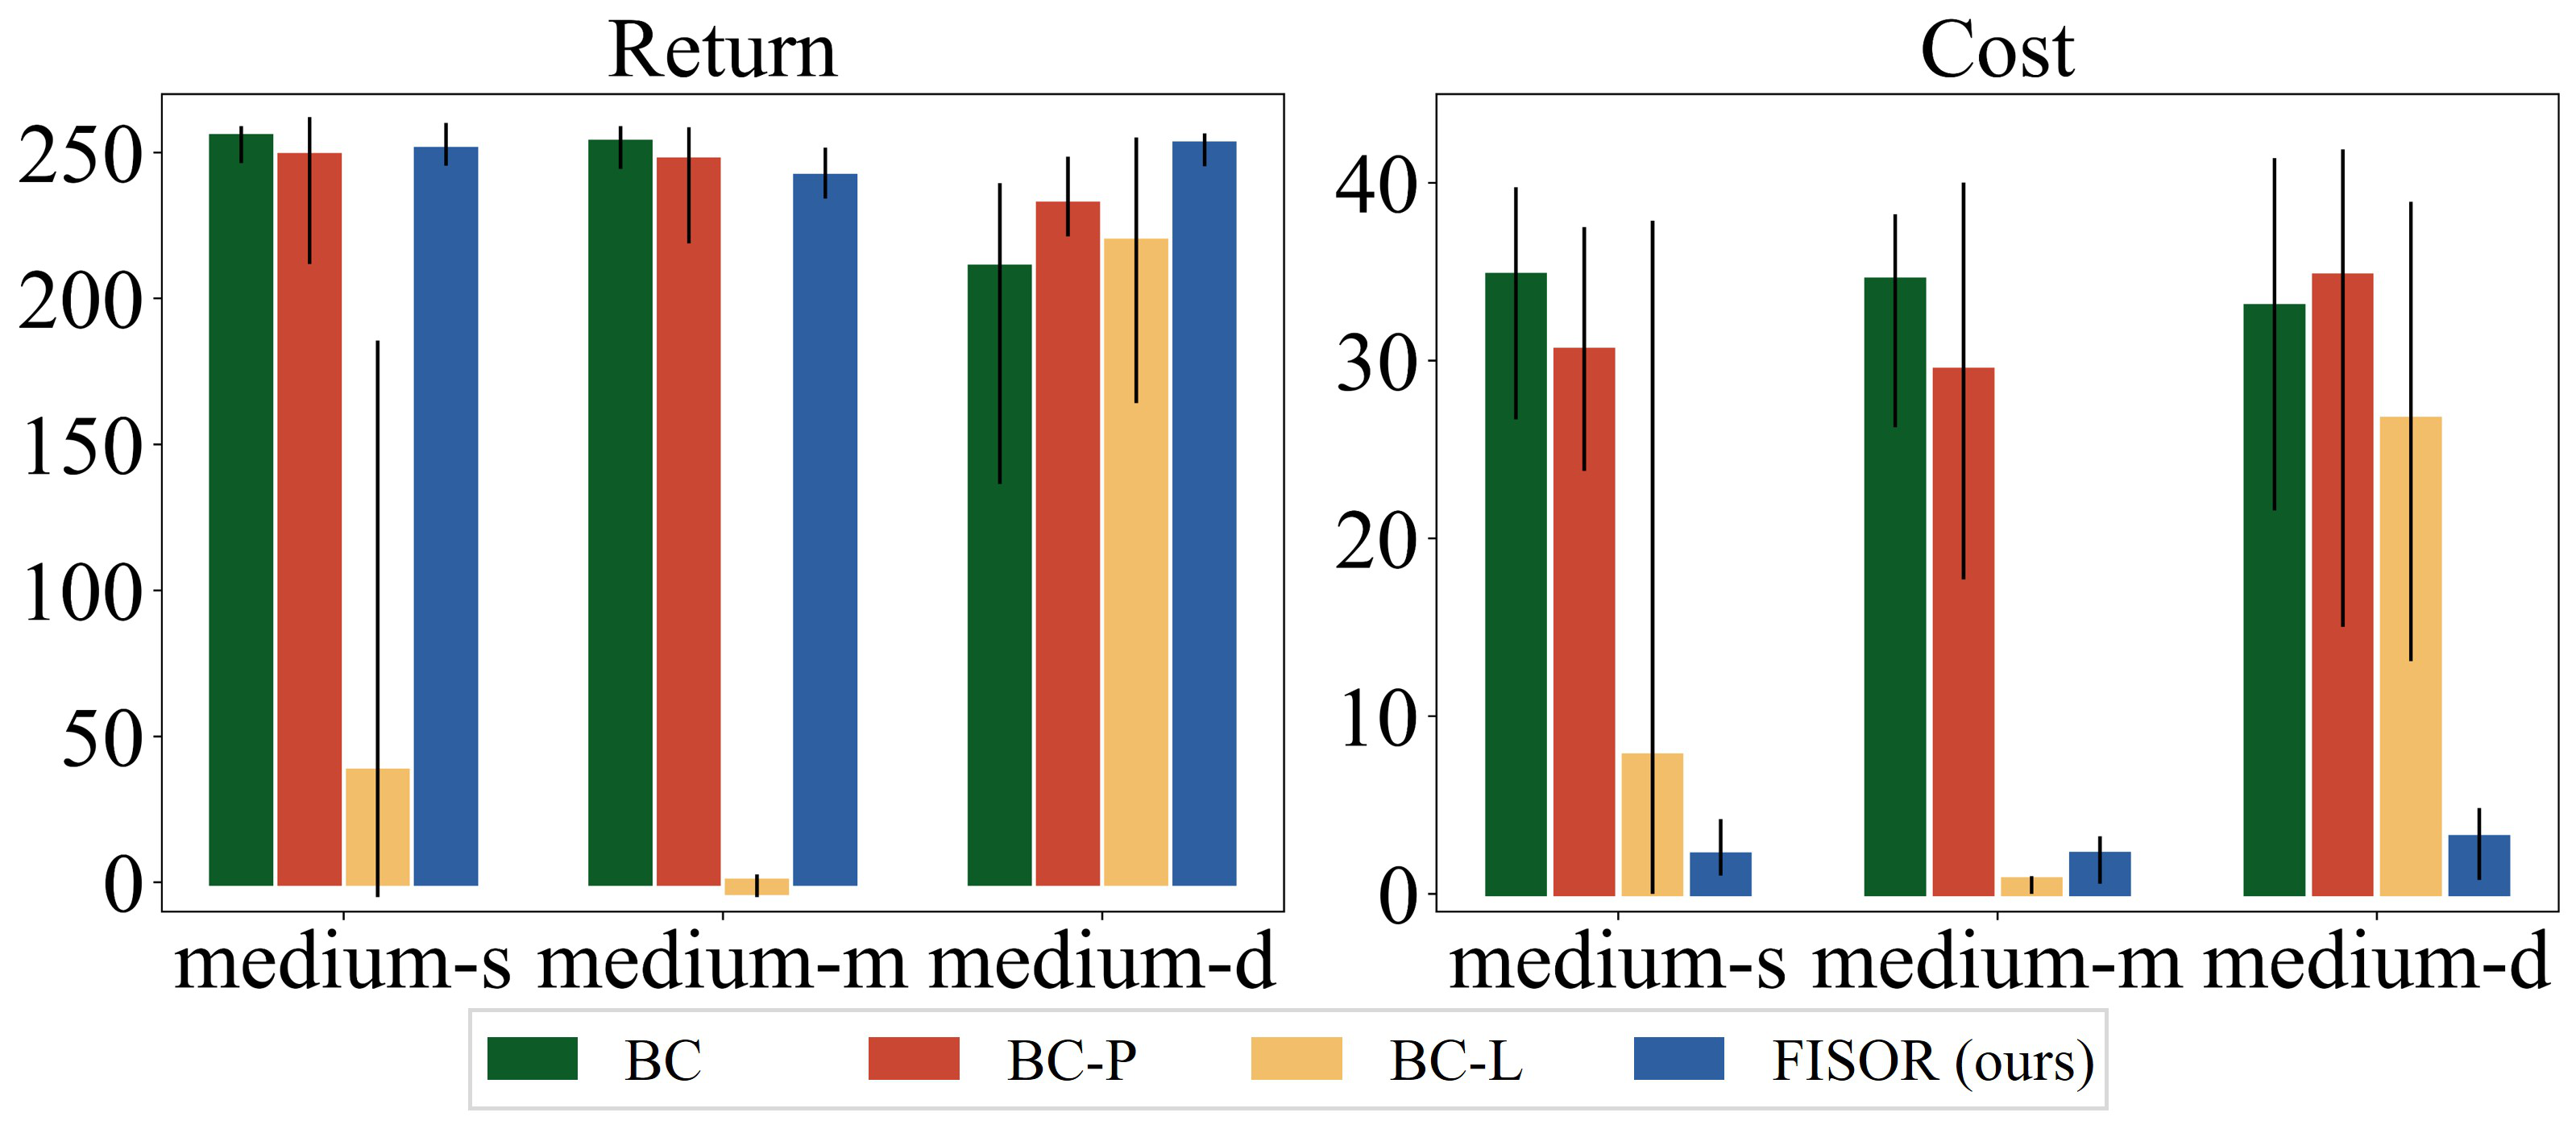
结果显示,FISOR 能够有效模仿专家行为、同时避免不安全结果,安全与模仿精度两方面均优于全部基线。这展示了可行性引导框架的通用性:回报最大化目标可以被整体替换,而"可行域识别 + 分区加权"的安全机制原样复用。
消融实验:可行域识别、不可行域目标与扩散策略缺一不可
去掉 HJ 可达性(w/o HJ):用成本值函数代替可行值函数来划分可行域时,近似误差会使估计出的不可行区域过大且不准确,导致策略过度保守、回报受损。在 Bullet-Gym 的 8 个任务上,FISOR 相对该变体全面占优,例如 AntRun 从 0.30/0.44 提升至 0.45/0.03,CarRun 从 -0.33/0.00 提升至 0.73/0.14,DroneCircle 从 -0.21/0.26 提升至 0.48/0.00——准确的最大可行域识别直接转化为更高的优化回报。
去掉不可行域目标或换掉扩散策略:论文在 Safety-Gymnasium 的 6 个 Car 任务上报告了归一化成本:把不可行域权重置零(w/o infeasible,即不学习"逃回安全区"的恢复行为)后违规急剧恶化;把扩散策略换成常规高斯策略(w/o diffusion)则无法同时拟合可行域内外的数据分布,同样带来高违规。
| 任务 | w/o infeasible 成本 ↓ | w/o diffusion 成本 ↓ | FISOR 成本 ↓ |
|---|---|---|---|
| CarButton1 | 4.61 | 0.72 | 0.26 |
| CarButton2 | 6.53 | 1.73 | 0.58 |
| CarPush1 | 0.86 | 1.21 | 0.28 |
| CarPush2 | 3.10 | 4.45 | 0.89 |
| CarGoal1 | 4.00 | 2.71 | 0.83 |
| CarGoal2 | 5.46 | 2.82 | 0.33 |
三组消融共同印证了论文的设计逻辑:HJ 可行值函数决定了"安全边界画得准不准",不可行域目标决定了"越界后能不能回来",扩散模型决定了"分区加权的复杂策略分布能不能被表达出来"——三者共同构成 FISOR 安全与性能的来源。
结语:让硬约束安全在离线设定下变得可解
FISOR 的核心贡献,是把"状态级零违规"这一以往只适用于在线设定的硬约束安全范式第一次带进离线强化学习:通过离线 HJ 可达性分析把硬约束转化为最大可行域识别,再以可行性依赖目标将安全约束满足、回报最大化与行为正则解耦为三个独立的监督学习过程,最后用无时变分类器的能量引导扩散模型完成策略提取。在 DSRL 基准 26 个任务上,它是唯一全部安全达标的算法,并在多数任务取得最高回报,且仅凭一组超参、无需逐任务调节成本上限;框架还可直接扩展到安全离线模仿学习。对"数据有限、安全攸关、无法在线试错"的真实工业决策问题,这条"先画可行域、再分区优化"的路线提供了一种兼具理论保障与工程稳定性的解法。
论文也坦诚讨论了局限:离线数据规模不足会削弱算法表现;由于安全约束只能施加在离线数据诱导的状态分布上,个别任务仍难以做到绝对零违规。将 FISOR 扩展为安全的离线到在线(offline-to-online)框架——在保持安全的前提下用在线交互进一步提升性能——是论文指出的可行未来方向。
论文作者:Yinan Zheng, Jianxiong Li, Dongjie Yu, Yujie Yang, Shengbo Eben Li, Xianyuan Zhan, Jingjing Liu(ICLR 2024)