核心结论:决策导向型工业表征模型将物理学中的时间反演对称性(T-Symmetry)作为先验硬约束嵌入隐空间连续动力学建模(TDM),并率先引入图卷积网络捕捉空间热力学拓扑;基于该表征构建的 TSRL 算法在 D4RL 基准上仅用原始数据集 0.5%–1% 的极端稀缺样本即取得与全量样本齐平甚至更优的性能,实现样本效率的百倍级跃升,同时把端到端的模型训练与策略寻优压缩到 20 分钟以内。
问题背景:数据匮乏极端工况下的工业决策之困
如果说决策算法是执行的大脑,那么决策导向型工业表征模型(即面向工业场景、专为决策服务的表征模型,下称“工业表征模型”)便是不可或缺的“认知中枢”。它致力于在数据匮乏的极端工况下,精准解构工业系统的底层动力学原理,为后续的寻优控制提供可靠的物理表征基座。该方向的核心基础理论已先后在全球人工智能国际顶级会议 ICLR 2026 与 NeurIPS 2023 中斩获突破性成果:
- Cheng, P., et al. Sample Efficient Offline RL via T-Symmetry Enforced Latent State-Stitching. ICLR 2026.
- Cheng, P., et al. Look Beneath the Surface: Exploiting Fundamental Symmetry for Sample-Efficient Offline RL. NeurIPS 2023.
这一困境在学术基准上同样尖锐。现有离线强化学习算法普遍依赖悲观保守的设计——限制策略偏离行为数据、对分布外(OOD)样本施加价值正则、或严格的样本内学习——其理论保证大多依赖“数据全覆盖”假设。NeurIPS 2023 论文的实验直观展示了后果:当 D4RL Walker2d 任务的训练数据从 100 万条缩减到 1 万条(1%)时,主流算法性能断崖式下滑,因为在小数据集下,绝大部分状态-动作空间都会变成 OOD 区域。论文的核心洞察由此而来:小数据场景下真正可利用的,是不随数据规模改变的系统底层对称性。
核心方法:把时间反演对称性嵌入工业表征模型
在连续的工业动态物理系统(如热能交换、流体控制)中,AI 不能像做单选题一样去“猜”下一步,而是必须掌握系统随时间运行的连续规律。为此,臻效智能在隐空间内构建了一套连续动力学表征架构。
具体来说,模型内部同时运行着两个神经常微分方程(Neural ODEs):
- 前向神经微分动力学(Forward Neural ODE):负责“顺流而下”,推演“如果现在施加某个控制动作,系统在未来会进行怎样的物理运行过程”。
- 逆向神经微分动力学(Reverse Neural ODE):负责“逆流而上”,回溯“要想达成当前的物理状态,系统在过去经历了怎样的物理运行过程”。
时间反演对称性的引入:仅依赖双向推演极易陷入数据拟合的陷阱。团队的核心突破在于,将物理学中的底层对称性法则——“时间反演对称性”,作为先验硬约束深度融入表征空间。在训练阶段,强制要求前向连续运行过程与逆向回溯必须保持“镜像对称”。简单来说:动力学系统怎么顺着时间流淌过去的,也能够逆着时间倒流回来。
这一机制不仅能自动过滤工业数据中因耗散或传感器误差引发的伪相关性噪声,更是确保后续离线 RL 算法能够安全、稳健地进行动作外推的核心物理锚点的关键依据。
TDM:T-symmetry 约束的动力学模型
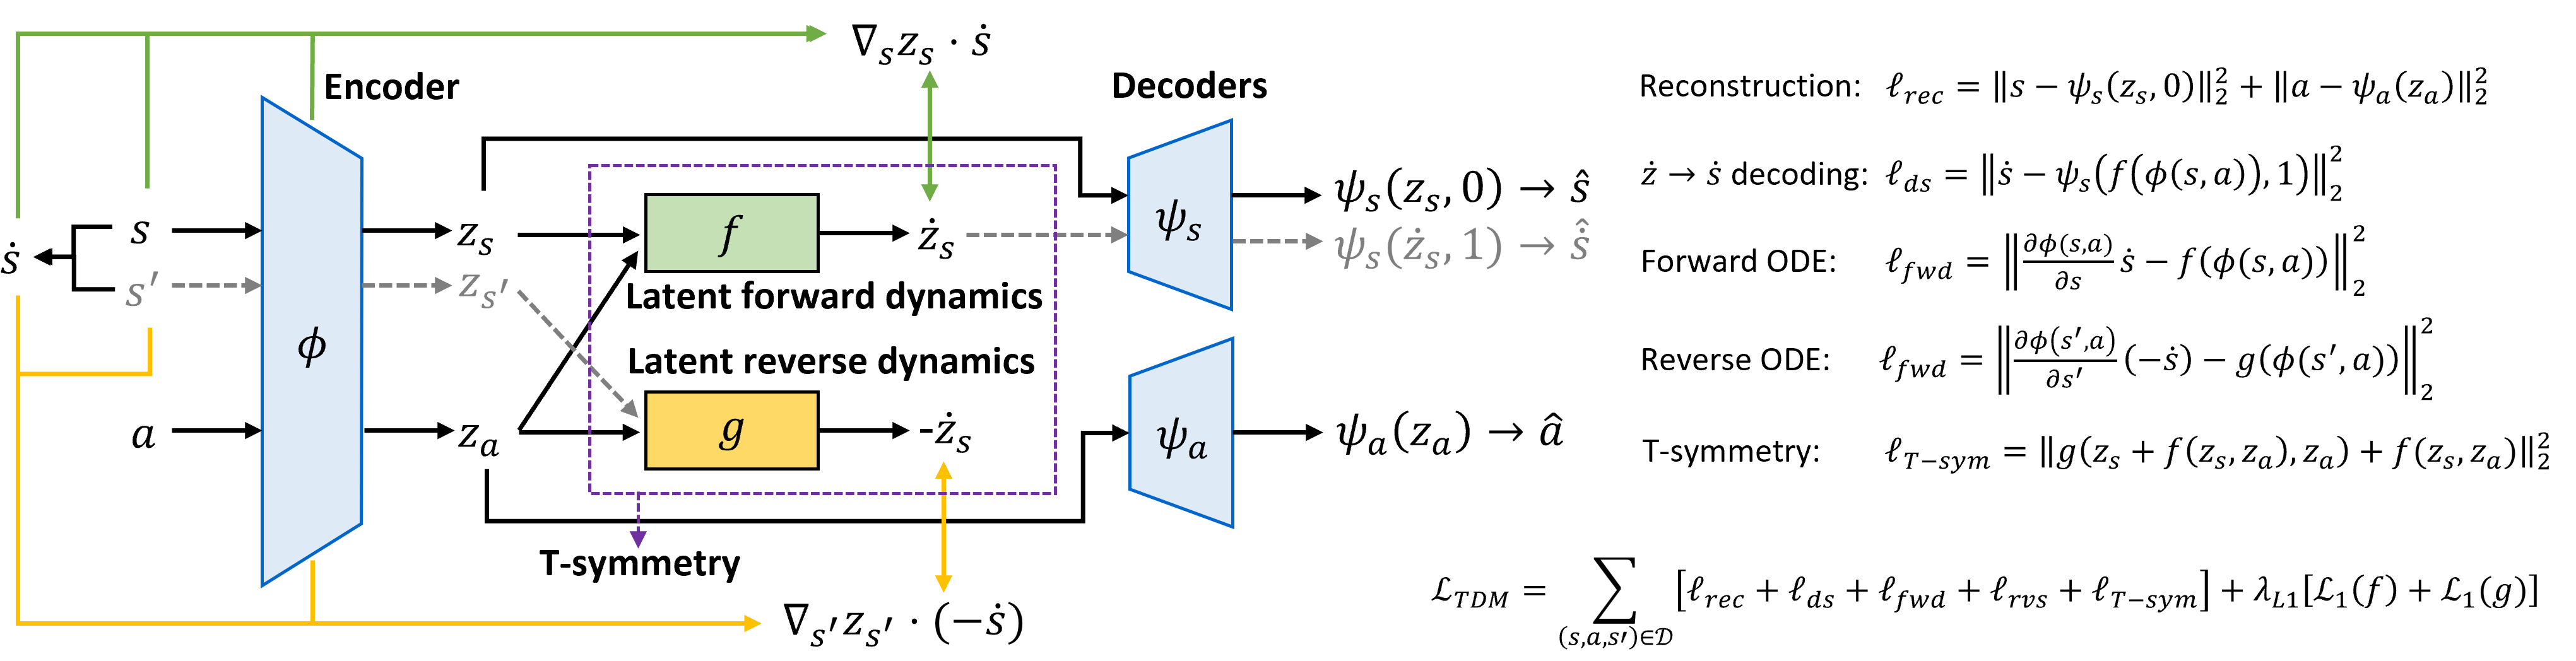
上述架构在 NeurIPS 2023 论文中被形式化为 T-symmetry enforced Dynamics Model(TDM),由四个部分构成:
- 状态-动作编码器与解码器:编码器 ϕ(s, a) = (zs, za) 把原始状态-动作对映射到隐空间;状态解码器不仅能从 zs 重构状态 s,还能从隐状态变化量 żs 解码出真实的状态变化 ṡ,保证隐空间与原始空间的动力学相互兼容。
- 前向隐空间 ODE 动力学:f(zs, za) = żs,以离散时间一阶 ODE 系统刻画隐状态随时间的正向演化;ODE 建模配合 L1 正则,鼓励模型学习简约、本质的动力学规律,避免小样本下的严重过拟合。
- 逆向隐空间 ODE 动力学:g(zs′, za) = −żs,刻画系统的逆向时间演化。它定义在“下一状态 + 当前动作”上,形式类似广泛使用的逆动力学模型——这一设计避免了不可逆动作(如摩擦)对对称性的破坏,是论文对经典时间反演对称性面向决策场景的关键扩展。
- T-symmetry 一致性约束:要求 f(zs, za) = −g(zs′, za)。实例级的一致性损失 ℓT-sym 不仅用于训练,还天然充当样本可靠性度量——一致性误差大的样本,往往就是模型无法解释的不可靠 OOD 样本。
值得一提的是,TDM 与基于模型的强化学习(MBRL)中的传统动力学模型有本质区别:后者学习前向转移预测,而 TDM 是一个内嵌 T-symmetry 保持 ODE 动力学的重构式模型,目标是“解释”系统而非“预测”系统——这正是它在小数据下更加稳健的根本原因。
TSRL:物理表征之上的小样本离线决策
基于 TDM,论文构建了 TSRL(T-Symmetry Regularized Offline RL)算法,从三个层面把物理先验转化为决策能力:
- T-symmetry 正则化表征:价值函数直接建立在 TDM 编码的隐表征 Q(ϕ(s, a)) 之上——表征同时兼容前向与逆向 ODE 动力学,即使在小数据下也能可靠外推。
- T-symmetry 正则化策略约束:用“隐动作偏差 + 策略诱导样本的 T-symmetry 一致性”替代传统的动作空间保守约束。如果一个 OOD 动作的隐表征与数据中动作相近、且满足 T-symmetry,它就被视为“可靠的 OOD 动作”而允许参与策略优化——策略由此得以在可靠区域内泛化,而不是被死死限制在数据覆盖区内。训练沿用 TD3+BC 式归一化,尺度参数 α₀ = 2.5 在所有实验中无需调参。
- T-symmetry 一致的隐空间数据增强:对隐状态施加小扰动生成新样本,再用 T-symmetry 一致性损失过滤——只保留一致性误差不高于数据集中位数/70% 分位水平的增强样本,以极低成本缓解小数据问题。
极小样本性能测试:样本效率的百倍级跃升
传统自控策略往往导致真实的工业历史数据分布极窄且充满噪声。团队所构建的工业表征模型最核心的行业壁垒在于:在数据质量低下、规模极度受限的严苛条件下,依然能够保持卓越的性能表现。
- 在“沙砾”中榨取“金子”:受限于传统自控策略的保守性,真实的工业历史数据通常分布极窄且夹杂大量噪声。但在我们看来,这些残缺数据中同样蕴含着不随数据规模改变的物理对称性规律。这就好比掌握了物理法则的专家,仅凭物体下落的三个点即可推算整条重力轨迹。通过 T-Symmetry 约束,我们直接从极少量数据中提取出恒定不变的底层法则,摆脱了对海量全工况数据的依赖。
- 率先引入空间物理拓扑先验:针对管网与热能交换等复杂系统,团队创新性地在模型中嵌入图卷积网络(GCN)以捕捉空间热力学拓扑,并将其与 Neural ODE 的动力学损失结合作为结构化正则项。这种直接为算法划定“空间物理边界”的设计,避免了盲目的数据相关性拟合,使得模型在极其有限的样本下,即可精准刻画出复杂系统的连续时空物理演变。
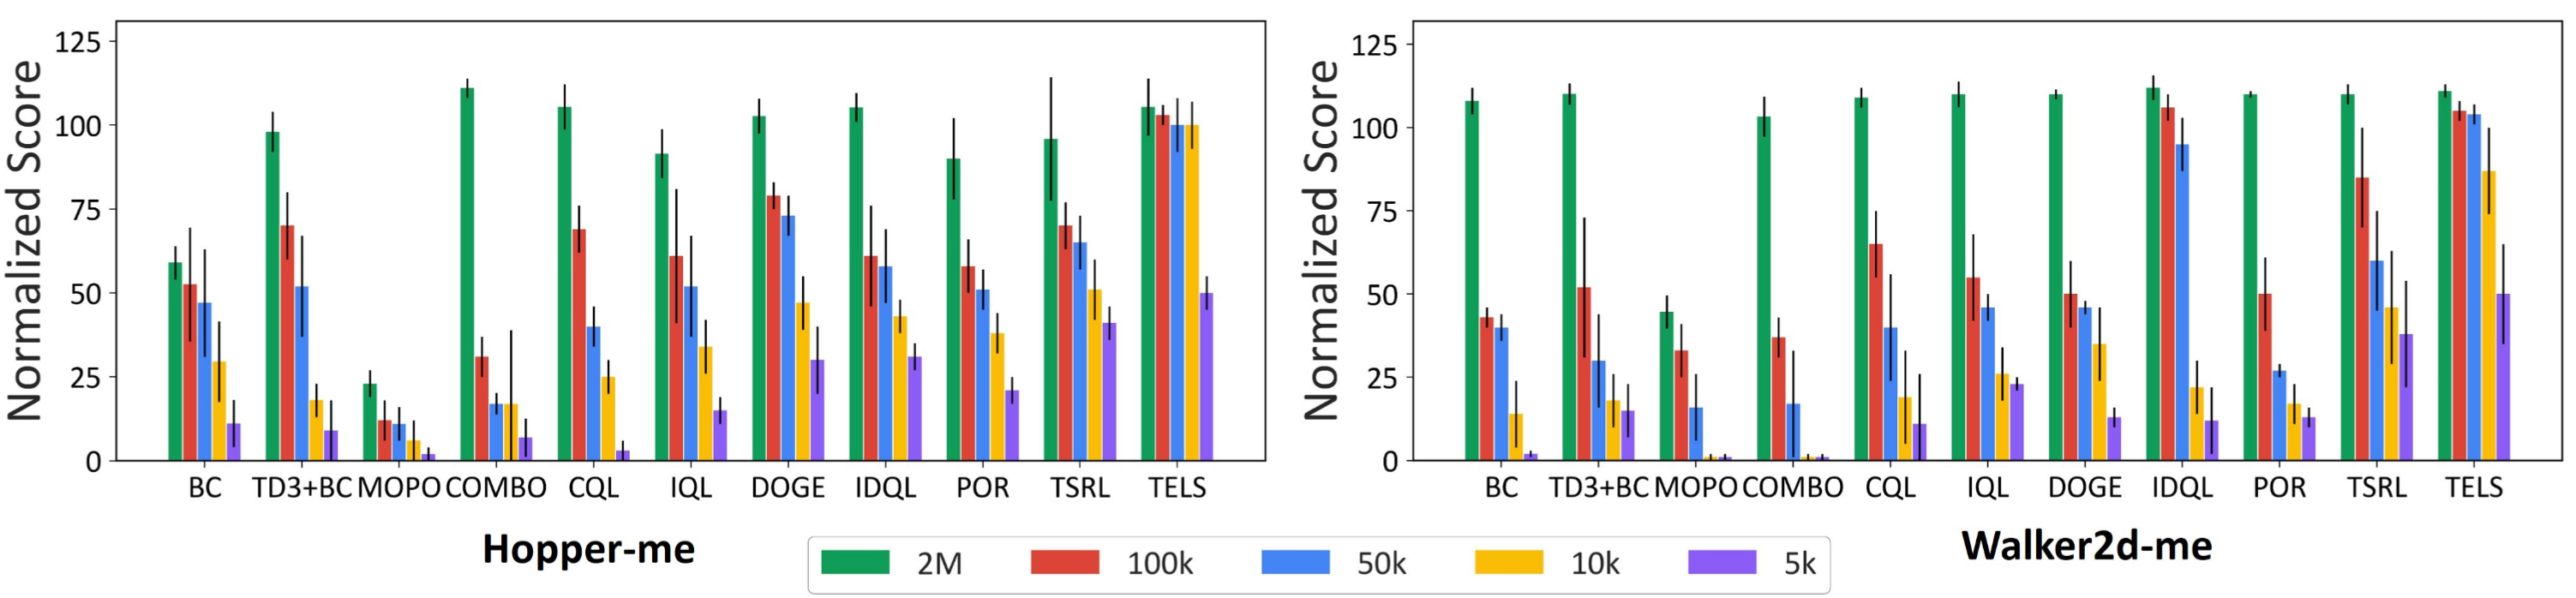
论文在 D4RL MuJoCo 与 Adroit 基准上系统验证了这种小样本能力:将完整数据集随机缩减到 5k–10k 条样本(约为原始规模的 1/20–1/200),与 BC、TD3+BC、MOPO、CQL、IQL 等主流方法对比。结果是全方位的领先:
| 任务 | 数据量 | 最强基线 | 基线分数 | TSRL | 亮点 |
|---|---|---|---|---|---|
| Hopper-m | 10k(1%) | IQL | 46.7 ± 6.5 | 62.0 ± 3.7 ↑ | 小数据下大幅反超全量数据训练的主流算法 |
| Hopper-me | 10k(0.5%) | IQL | 34.3 ± 8.7 | 50.9 ± 8.6 ↑ | 数据压缩 200 倍仍稳定领先 |
| Walker2d-m | 10k(1%) | IQL | 22.5 ± 3.8 | 49.7 ± 10.6 ↑ | 超过最强基线两倍 |
| Walker2d-me | 10k(0.5%) | IQL | 26.5 ± 8.6 | 46.4 ± 17.4 ↑ | 混合质量数据下优势显著 |
| Walker2d-e | 10k(1%) | CQL | 41.6 ± 21.6 | 102.2 ± 11.3 ↑ | 逼近全量数据水平(110.2) |
| Halfcheetah-e | 10k(1%) | CQL | 4.2 ± 0.9 | 40.6 ± 24.4 ↑ | 多数基线完全失效,TSRL 唯一有效 |
| Adroit-human | 5k(原始小数据) | IQL | 77.3 | 80.9 ± 21.1 ↑ | 真实人类演示小数据上同样领先 |
几点补充观察同样重要:其一,TSRL 在全量数据上也不落下风(如 Hopper-m 全量数据下 TSRL 86.7,IQL 66.3);其二,在 100 万到 5k 条的数据量扫描实验中,多数基线在 10k 以下性能急剧退化,而 TSRL 在仅 5k 条样本时仍保持可用性能;其三,同为动力学模型路线的 MOPO 在小数据下表现糟糕,说明小样本场景需要的正是 TDM 这类受良好正则的表征模型,而非普通的预测式动力学模型。
强泛化能力实验验证:删掉高速样本后,策略仍能跑出高速行为
最能体现 T-symmetry 技术价值的,是论文设计的一组“人为制造 OOD”实验:从 Walker2d-medium 数据集中删除所有 x 方向速度最高 20% 的样本,只保留约 20 万条低速数据——这意味着大量转移动力学从未在训练数据中被观测到。
- 基线集体失效:在低速数据上训练时,主流离线 RL 算法表现糟糕——过度保守的数据相关正则让策略无法离开数据覆盖区,而 OOD 区域此时恰恰占据状态-动作空间的主体。
- TSRL 泛化到未见行为:TSRL 依然学到了良好策略;对策略实际 rollout 的速度分布分析显示,它确实产生了训练数据中完全不存在的高速行为。
- 背后的原因:T-symmetry 捕捉的是低速与高速数据中保持不变的本质动力学规律,因此面对缺失区域仍能做出符合物理规律的外推,而非单纯记忆数据分布。
这与工业现场的现实直接对应:受安全约束,真实历史数据永远只覆盖保守运行区,而更优的控制策略恰恰常常位于数据覆盖区之外。
训练效率验证:分钟级模型构建与策略寻优
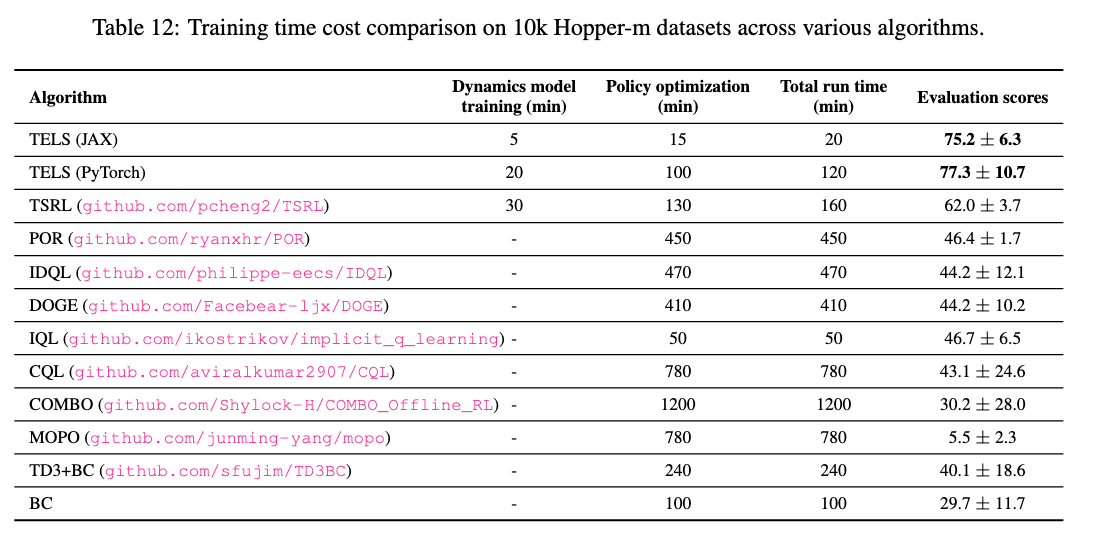
在真实的工业部署与运维中,算法的落地成本往往取决于其迭代与适配的速度。传统离线强化学习算法在面对高维工业数据时,由于需要在庞杂、充满噪声的原始状态空间中进行低效的试错与拟合,其训练动辄耗费十余小时乃至数天,严重阻碍了工程侧的敏捷部署。
基于团队提出的表征决策协同架构,算法在训练效率与寻优性能上实现了真正的代际跨越:
- 分钟级训练闭环:依托底层强大的物理先验约束,工业表征模型仅需极短的时间(约 5 分钟)即可完成动力学模型的训练;随后,决策模型仅需 15 分钟便能完成策略训练优化。整体端到端的模型运行与寻优时间被极致压缩至 20 分钟内。
- “快”与“好”的完美统一:相比于主流离线决策算法,团队算法将整体训练耗时缩短了 30 至 60 倍。在训练时长断崖式下降的同时,算法性能不仅没有折损,性能提升幅度高达 60% 至 150%。
这种极速、轻量且高性能的训练范式,使得算法在面对环境漂移或设备更替时,能够以极低的算力成本完成高频、敏捷的模型自适应微调,为前沿算法在工业场景下的规模化复制与低成本调试创造了核心条件。
消融实验:双向动力学、ODE 结构与 T-symmetry 缺一不可
论文通过多组消融逐项验证了方法中每个设计的贡献。在表征质量上(论文 Figure 4):分别用自编码器(AE)、带前向动力学但无 ODE 结构与 T-symmetry 正则的自编码器、以及流行的自监督方法 SimSiam 替换 TDM 表征,TDM 表征在所有小数据任务上取得最优;去掉 ODE 结构的 TDM 变体则一致差于完整版本。这说明双向动力学设计与 T-symmetry 正则是性能提升的核心,ODE 结构进一步带来稳定的收益。
在数据增强上(论文 Figure 5):与 S4RL 的零均值高斯噪声增强相比,T-symmetry 一致的隐空间增强收敛更快、方差更小;盲目添加随机扰动会随训练进行出现性能退化,而经 T-symmetry 一致性过滤的增强样本全程保持稳健。在组件层面(论文 Figure 6):去掉 T-symmetry 正则化表征或策略约束都会明显损失性能,数据增强则有正向加成;作为对照的 TD3+BC 在小数据上随训练步数增加出现显著过拟合,而完整的 TSRL 没有这一现象。
正则强度本身也被仔细检验(论文附录 Table 7):TDM 的正则过松或过强都会损害性能——以 Hopper-m 10k 为例,过松为 50.7、论文默认设置为 62.0、过强则降至 43.6。这印证了论文的判断:恰到好处的物理约束,而不是越多越好或越少越好的正则,才是小样本性能的真正来源。
结语:为工业决策打造可靠的物理表征基座
工业表征模型的核心价值,在于把“不随数据规模改变的物理规律”变成算法可以依赖的先验:时间反演对称性为隐空间动力学提供了物理锚点,图卷积捕捉的空间热力学拓扑则划定了空间物理边界。两者结合,使模型在分布极窄、噪声密集的真实工业历史数据上依然能够精准解构系统底层动力学——样本效率实现百倍级跃升,训练与寻优进入分钟级时代。
基于这一表征基座的 TSRL,是首个在低至 1% 原始样本的极端小数据集上展现出竞争力的小样本离线强化学习方法;论文也坦诚其局限:动力学与对称性正则会损失一部分模型表达能力,但在小数据场景下,这是精度与泛化之间值得的权衡。在此之上,团队进一步构建了完整的离线决策优化训练体系,并在数据中心冷却等真实工业场景中完成落地验证。相关基础理论已发表于 ICLR 2026 与 NeurIPS 2023。
论文作者:Peng Cheng, Xianyuan Zhan, Zhihao Wu, Wenjia Zhang, Shoucheng Song, Han Wang, Youfang Lin, Li Jiang(NeurIPS 2023)