核心结论:论文提出一套物理信息增强的离线强化学习框架,用图结构抽象与时间反演对称性(T-symmetry)约束的热动力学模型 TTDM,在有限、窄覆盖的历史运行数据上学习机房冷却控制策略;系统在大型商业数据中心累计闭环运行 2000 小时,冷却系统节能 14–21% 且全程零安全违规,并在 22 台服务器的真实测试平台上全面优于 PID、MPC 与主流离线强化学习基线。
问题背景:数据中心冷却控制的“小数据、强约束”困境
数据中心正成为现代社会最关键的基础设施之一,也随之带来巨大的能源消耗。2022 年全球数据中心用电量估计为 240–340 TWh,约占全球电力需求的 1–1.3%;据国际能源署预测,到 2026 年美国数据中心用电将升至全国总用电量的约 6%。在典型大型数据中心里,冷却系统约占总能耗的 30–40%——与主要消耗在计算任务上的服务器侧能耗相比,降低冷却能耗具有更直接的节能价值。
然而,机房层面的冷却控制是一个困难的工业控制问题,挑战来自三个方面:
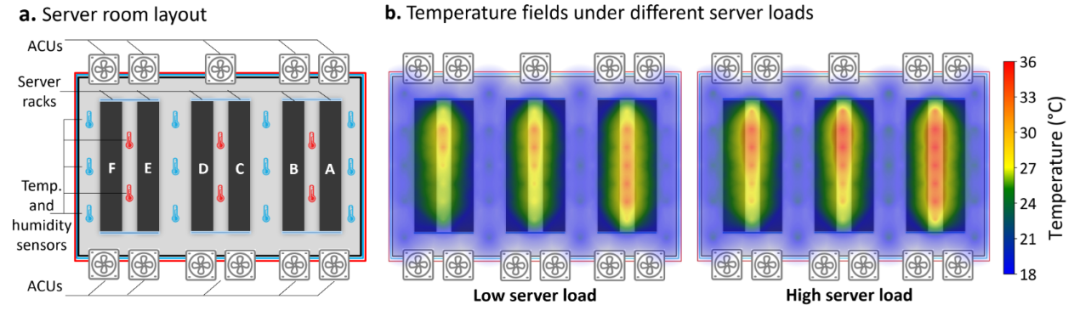
- 温度场复杂且动态变化:服务器负载频繁变化、物理位置各异,在机房内形成复杂多变的温度场。要达到最大的节能程度,需要对多台精密空调(ACU)做完全负载感知的联合控制,并能刻画复杂的热动力学过程。
- 安全与运行约束严格:商业数据中心对热安全有严苛要求(如冷通道温度不得超过阈值),不当控制会直接影响服务器运行,节能与安全之间的平衡很难把握。
- 高保真仿真器难以构建:基于 CFD 或多物理场仿真的尝试受制于繁琐的系统辨识与校准,存在难以避免的 sim-to-real 鸿沟,使得基于仿真的在线强化学习策略几乎无法在真实数据中心部署。时至今日,大多数数据中心仍依赖人工调参的本地 PID 控制器,为防止过热而保守运行。
离线强化学习提供了一条不依赖仿真器、直接从历史运行数据学习策略的数据驱动路线。但现有离线 RL 算法大多需要大量且覆盖充分的状态-动作数据,否则性能会严重退化;而真实数据中心的历史运行数据恰恰规模有限、覆盖狭窄——它们由既有的传统控制器产生。这一现实对可部署的离线 RL 模型提出了严苛要求:必须具备足够强的分布外(OOD)泛化能力与小样本学习能力。这正是本论文要解决的核心问题。
核心方法:把时间反演对称性写进热动力学模型
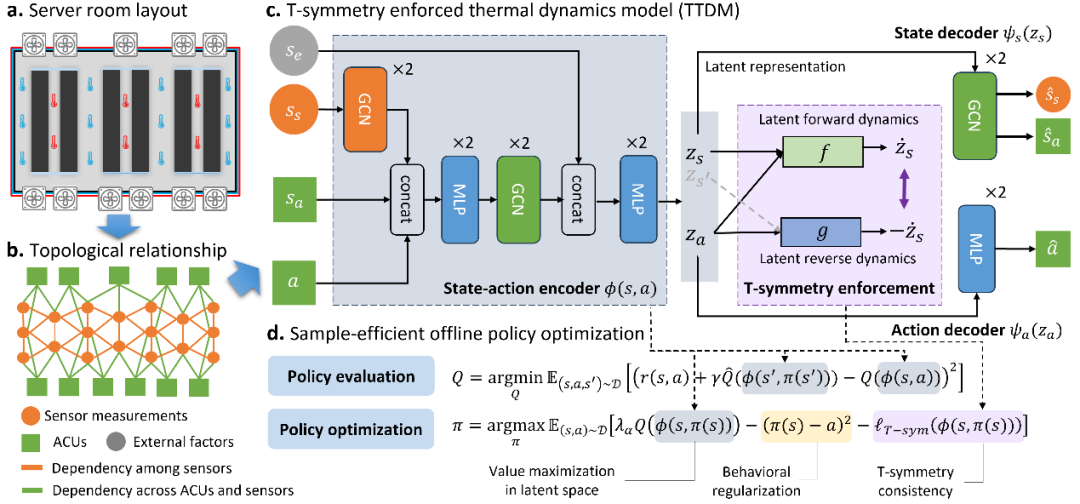
论文提出一套物理信息增强的离线强化学习(physics-informed offline RL)框架,整体结构如下图所示:先将冷却控制问题建模为马尔可夫决策过程(MDP),再构建一个符合时间反演对称性的热动力学模型来学习鲁棒、可泛化的隐空间表征,最后在隐空间中完成样本高效的离线策略优化。
问题建模与安全感知奖励设计
状态包含三类输入:冷热通道温湿度传感器与机柜温度读数、各 ACU 的工作状态(出水温度、送风温度、回风温度等),以及无法被楼面级冷却系统控制的外部因子(各 ACU 进水温度与服务器功耗)。真实机房的状态向量经特征工程后约 80 维,以 2–5 分钟间隔采集。动作则是机房内每台 ACU 的风机转速与水阀开度——对 11 台 ACU 的机房即 22 维连续动作。奖励函数在节能与温控之间做权衡:风机功耗与转速的立方成正比,同时对冷通道温度越过安全阈值、送风温度越过预设阈值施加软惩罚。
TTDM:T-symmetry 约束的热动力学模型
为从历史数据中提取鲁棒且可泛化的表征,论文构建了 T-symmetry enforced Thermal Dynamics Model(TTDM):
- 图结构抽象:把机房抽象为两个耦合的图——传感器节点之间按空间相关性连边,传感器与 ACU 节点之间按控制依赖关系连边,将领域知识直接嵌入模型结构。
- GCN 状态-动作编码器:编码器由一对图卷积(GCN)模块构成,分别捕捉传感器间的空间依赖与传感器-ACU 间的控制依赖;外部因子经两层 MLP 融合进最终隐表征。
- 正反向隐空间 ODE 动力学:引入一对隐空间 ODE 正向动力学 f 与反向动力学 g 来刻画系统随时间正反两个方向的演化;ODE 建模鼓励学习简约的模型,捕捉数据中更本质的规律,从而避免小样本学习中常见的严重过拟合。
- 时间反演对称性约束:要求正反向动力学满足 T-symmetry 一致性 f(zs, za) = −g(zs′, za),与重构损失、正反向 ODE 损失等共同构成 TTDM 的训练目标,过滤不符合基本动力学规律的表征。
隐空间中的样本高效离线策略优化
TTDM 编码器产出的隐表征既信息丰富(捕捉了本质动力学信息)又足够鲁棒(受良好正则且保持 T-symmetry)。基于此,论文的策略学习不再像常规 RL 那样在原始数据空间学习动作价值函数,而是分三步在隐空间完成:隐空间价值最大化——学习并最大化 Q(zs, za),即使在有限数据下也能得到更可靠的价值估计;行为正则——约束策略输出动作贴近数据集中的行为动作;T-symmetry 一致性正则——要求策略诱导的样本同样满足 T-symmetry 一致性,使策略即使在 OOD 区域也能生成符合动力学规律的动作。训练沿用 TD3+BC 风格的归一化项平衡价值最大化与正则强度,其中尺度参数 α 在 [2.5, 10] 区间内调优。
极小样本性能测试:用百分之一量级数据解决高维控制问题
这项工作中模型可用的真实数据,远少于常见离线 RL 基准:Room A 收集了约 20 个月的历史运行数据,共约 18 万条样本(5 分钟间隔、108 维状态-动作特征);Room B 约 15 个月、约 14 万条样本(101 维特征);真实测试平台则为 61 天、约 4.3 万条样本(2 分钟间隔、105 维特征)。作为对照,D4RL 等基准常常使用 100 万条样本去学习简单得多的任务——而本问题的规模要大得多。
不仅量少,数据分布还很窄。论文对真实数据中心历史数据的分析表明:由于历史上 ACU 始终处于 PID 群控、温度设定值极少调整,系统动作(风机转速与水阀开度)的模式分布非常狭窄,其他状态特征的分布也大多呈单峰集中。这些因素叠加,对离线 RL 策略学习构成了显著挑战,要求模型具备很强的泛化能力才能从有限经验中学到更优控制策略。
结果上,框架正是在这样的小样本、窄覆盖数据上训练出了可实际部署的策略:在测试平台上,所有对比方法都使用同一份约 4.3 万条样本的数据集训练,本文方法在各负载条件下仍取得最高能效且全程零温度违规(详见“工业场景控制验证”一节);在数据分布更窄、控制维度更高的生产机房中,学得的策略同样安全落地。这直接验证了 TTDM 的 ODE 简约建模与 T-symmetry 约束所带来的小样本学习能力。
强泛化能力实验验证:负载怎么变,策略都跟得上
论文通过多组长周期、变工况实验检验策略在未见负载条件下的泛化与鲁棒性。最核心的证据来自 Room B 的两组 14 天连续实验:本文模型于 2024 年 6 月 17 日至 7 月 1 日连续控制 4 台可控 ACU,PID 控制器则于 7 月 2 日至 16 日运行。
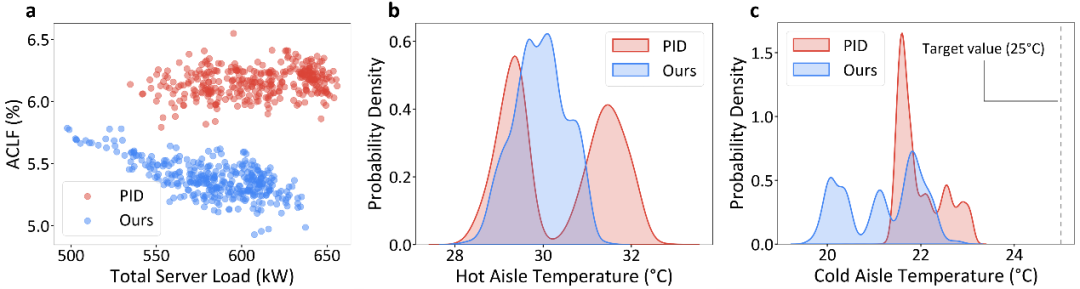
- 全负载区间一致更优:在所有服务器负载条件下,本文方法的 ACLF 都稳定低于 PID;且负载越高、ACLF 越低——策略具备负载感知能力,负载上升时节能更多,与 PID 几乎恒定的 ACLF 水平形成鲜明对比。
- 更均匀的温度场:PID 控制下热通道温度呈聚集在 29°C 与 31.5°C 附近的双峰分布,本文方法则将其维持在 30°C 附近、分布更集中,热通道温度场更均匀;两种方法都将冷通道温度控制在 25°C 运行阈值以下。
在更极端的负载骤降骤升场景中(论文附录 8.3),同一机房内一台 ACU 由 PID 控制、另一台由本文方法控制:PID 几乎没有调整风机转速、仅微调水阀开度,而离线 RL 策略能迅速适应外部变化,给出更优且更节能的控制动作。48 小时连续对比实验(附录 8.1)进一步显示,本文方法的控制行为全程动态而平稳——整体倾向于降低风机转速、略增水阀开度,在更少 ACU 能耗下维持同等冷量,冷通道温度甚至略有下降,且未出现 PID 运行期间曾发生的短时剧烈调节。
工业场景控制验证:2000 小时真实闭环部署
论文作者开发了一套完整的软件系统支撑闭环控制,并于 2024 年 1 月至 12 月在中国某大型商业数据中心的两个机房开展实验——机房承载真实视频业务负载,Room A 服务器平均负载约 550 kW、ACU 总功耗约 25 kW(11 台 ACU),Room B 约 610 kW、约 37 kW(10 台 ACU)。实验分阶段推进:初期仅获准控制 4 台 ACU,验证有效后扩展到 6 台,最终控制全部 ACU;系统累计安全运行超过 2000 小时,全程无任何热安全违规。
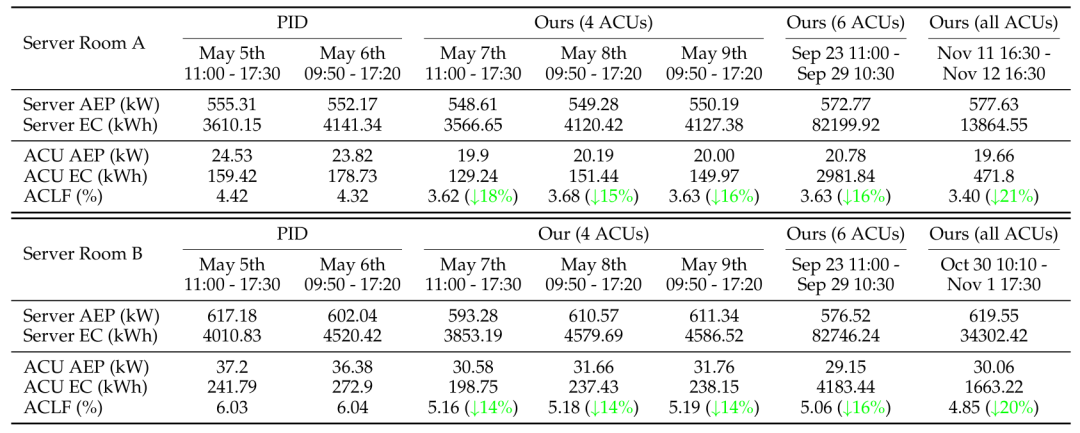
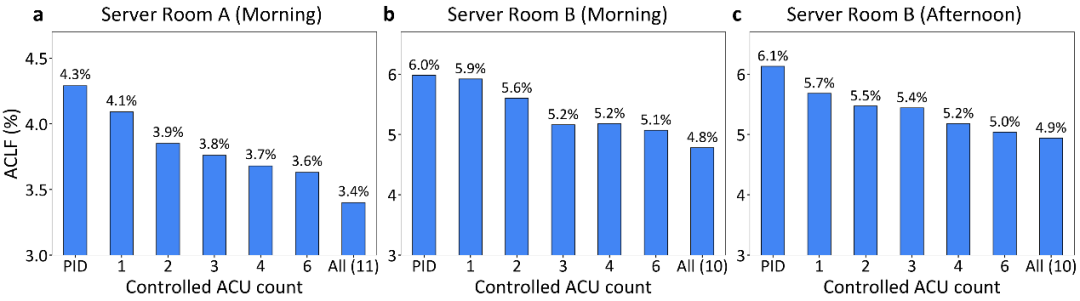
在可比服务器负载条件下,以数据中心行业通用的 ACLF(空调能耗与服务器能耗之比,越低越好)衡量:Room A 从 PID 的 4.32–4.42% 降至 3.40–3.68%(节能 15–21%),Room B 从 6.03–6.04% 降至 4.85–5.19%(节能 14–20%),两个机房合计实现 14–21% 的冷却系统能效提升,且冷通道温度全程被稳定控制在运行阈值以下。论文还测试了由模型控制 1 台到全部 ACU 的不同规模:接管的空调越多,ACLF 越低(例如 Room A 上午时段从 PID 的 4.3% 单调降至全量控制的 3.4%),说明方案具有良好的规模可扩展性。
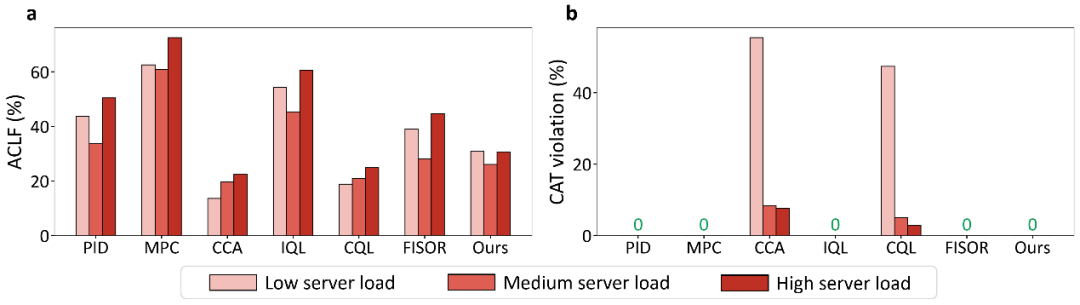
由于生产环境不允许测试安全性无法保障的其他方法,论文另外搭建了一个含 22 台真实服务器与一台列间空调的小型测试平台,采用更严苛的 22°C 冷通道温度阈值,在低(4.9 kW)、中(7.4 kW)、高(8.0 kW)三种负载下对各方法做 6 小时闭环对比。结果显示:本文方法在所有负载条件下能效均为最高,且全程零冷通道温度违规;而较激进的基线 CCA 与 CQL 虽然能耗更低,却以严重的热安全违规为代价(CCA 在低负载下违规率超过 50%),在真实工业场景中不可接受。
消融实验:GNN 先验与 T-symmetry 缺一不可
论文在测试平台上对方法的关键设计做了逐项消融。针对 TTDM 模型本身,在 Room B 历史数据上比较有无 GNN 结构、有无 T-symmetry 约束时的多步前向预测误差(MSE):引入领域知识(传感器与 ACU 之间的空间及控制依赖)的 GNN 模块显著降低了预测误差,且预测步数越多优势越明显;T-symmetry 约束也带来类似幅度的改善。这说明两种设计都能实质提升热动力学模型的建模能力与泛化性,从而为离线数据集提供更好的表征。
在策略层面,论文进一步在测试平台低、高两种负载下各做 6 小时闭环实验,比较有无 T-symmetry 的离线 RL 版本:带 T-symmetry 的完整方法在两种负载下都取得了明显更好的能效改善,表明 T-symmetry 在策略学习阶段对泛化能力起着关键作用——正是它让策略在真实数据有限时依然表现可靠。
针对奖励函数设计,论文测试了冷通道温度违规惩罚权重 β2 取默认值、5 倍与 10 倍的三组模型(测试平台、低/高负载各 6 小时)。所有实验中冷通道温度均被控制在阈值以下,且不同 β2 下的 ACLF 相当接近,说明奖励设计鲁棒、不需要精细调参即可获得良好的实际性能——这对真实部署尤为重要。
| 奖励权重设置 | 默认 β₂ | 5×β₂ | 10×β₂ |
|---|---|---|---|
| 低负载下 ACLF (%) | 29.66 | 29.37 | 30.95 |
| 高负载下 ACLF (%) | 26.89 | 27.50 | 26.05 |
结语:让离线强化学习真正走进工业控制现场
这篇论文的核心贡献,是构建了一套物理信息增强的离线强化学习框架与可部署系统:以图结构 + T-symmetry 一致的热动力学模型 TTDM 提供鲁棒、可泛化的表征,使小样本隐空间离线策略学习成为可能;系统最终在真实大型商业数据中心完成闭环部署,累计 2000 小时实验中实现 14–21% 的冷却节能且零安全违规,并在专门搭建的真实测试平台上通过了全面的基线对比与消融验证。
这项工作展示了离线强化学习在解决一大类“数据有限、安全攸关、无法构建高保真仿真器”的真实工业控制问题中的巨大潜力。论文最后也呼吁强化学习社区走出基于玩具仿真的基准环境,更多关注真实世界的控制问题——因为现有仿真基准中许多不真实的设定,往往会给出与真实实践相悖的误导性结论。
论文作者:Xianyuan Zhan, Xiangyu Zhu, Peng Cheng, Xiao Hu, Ziteng He, Hanfei Geng, Jichao Leng, Huiwen Zheng, Chenhui Liu, Tianshun Hong, Yan Liang, Yunxin Liu, Feng Zhao(ICLR 2025, RLC Workshop)