核心结论:基于高样本效率、高泛化离线强化学习(Offline RL)的数据中心风侧冷却系统能耗优化方案,在全球范围内首次将离线强化学习技术应用于复杂工业系统的可靠闭环控制;已在大规模商业数据中心实现超 2000 小时安全稳定运行,冷却系统能效提升 14%–21%(↓ACLF)。研究成果《Data Center Cooling System Optimization Using Offline Reinforcement Learning》已被 ICLR 2025 接收。
一、研究背景:数据中心能耗挑战与 AI 工业落地的复杂性
随着信息技术和人工智能的迅猛发展,数据中心(DC)行业在全球范围内迅速扩张,随之而来的是对电力资源的巨大需求。在典型的大型数据中心中,年耗电量可超过一亿度电,其中冷却系统的能耗可占总能耗的 30%–40%。因此,如何提升数据中心冷却系统的能效,成为当前亟待解决的问题。
然而,数据中心冷却系统的优化并非易事:
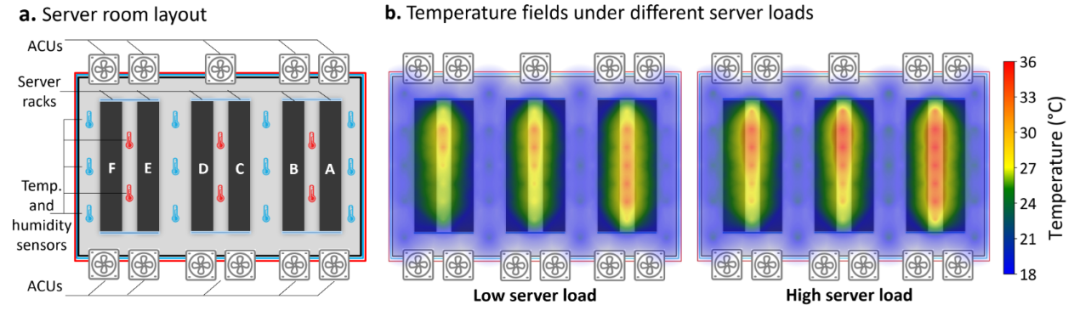
- 环境复杂动态:机房内大量服务器负载变化频繁,机房内部温度场分布复杂且动态变化;
- 控制高度复杂:涉及多个空调单元协同制冷、严格的温湿度安全约束、高度动态化的外部服务器负载变化以及复杂的热力学环境;
- 传统控制的局限:传统工业控制器仅能实现各设备的局部控制,无法对高维复杂控制问题进行全局优化,且控制层面缺乏灵活性,难以应对负载的快速变化;
- 仿真器难以构建:数据中心环境复杂,构建高保真度仿真器极为困难,基于仿真的传统在线强化学习方法难以在实际数据中心中部署落地。
近年来兴起的离线强化学习(Offline RL)为工业控制提供了一种不依赖仿真环境的全新数据驱动解决方案,但其在实际工业应用中仍面临诸多挑战:
- 离线强化学习通常需要大量且覆盖全面的数据,而现实中冷却系统的历史数据非常有限,且大多来自传统控制器,数据覆盖范围较窄,模型容易出现过拟合或性能下降;
- 冷却系统控制本身的复杂性,对离线策略学习提出了极高的要求。
关键挑战:如何在数据有限的情况下,实现小样本、高泛化、高可靠的离线强化策略学习,是解决包括数据中心节能优化等广泛实际工业控制优化问题的关键。
二、核心方法:基于物理信息的高泛化离线强化学习框架
针对上述挑战,研究提出了一种基于物理信息的离线强化学习(physics-informed offline RL)框架。该方法不仅克服了历史数据有限性和覆盖范围局限性的问题,还能够在复杂动态的机房环境中实现高效、安全的控制。
2.1 热动力学建模:TTDM(时间反演对称性约束的热动力学模型)
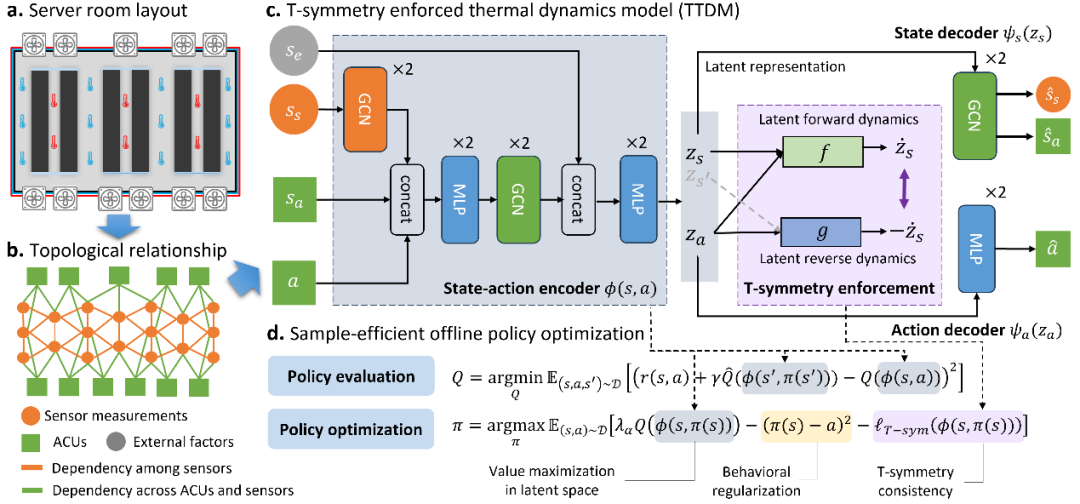
为了实现样本高效、高泛化的离线策略学习,受物理学中广泛存在的时间反演对称性(Time Reversal Symmetry,T-symmetry,即物理定律在时间正向和反演运算下保持不变)的启发,研究设计了特殊的环境热动力学模型——时间反演对称性约束的热动力学模型(T-symmetry enforced Thermal Dynamics Model, TTDM),以准确捕捉机房内部复杂的热动力学模式,并为离线策略优化提供鲁棒且可泛化的数据表征:
- 图结构抽象:将机房内所有空调、温湿度传感器、服务器机柜等设备对象的空间分布及其相互影响关系抽象为图结构;
- 领域知识嵌入:通过由图卷积网络(GCN)构成的编码器,将领域知识嵌入模型之中;
- 对称性约束:引入一对隐空间上的正向及逆向常微分方程(ODE)动力学模型,构造并约束整个系统满足时间反演对称性,从而增强模型的可靠性与泛化能力。
2.2 样本高效的离线策略优化:从有限数据中榨取最优控制模式
TTDM 的编码器包含丰富的基础动力学信息且具有极强的鲁棒性。研究充分利用这一特性,其离线策略优化由三部分组成:
| 组成 | 做法 | 作用 |
|---|---|---|
| 隐空间价值最大化 | 不在原始数据空间、而是在 TTDM 编码的隐空间中学习并最大化价值函数 | 大幅提升价值函数学习过程的稳定性 |
| 行为正则化 | 约束策略模型输出趋近于离线数据 | 保证策略不脱离安全的数据分布 |
| T-symmetry 一致性 | 要求策略符合 TTDM 中的时间反演对称性关系 | 增强数据分布外(OOD)泛化能力,在真实数据极其有限时显著提升学习效果 |
三、实验验证:大规模商业数据中心中的成功应用
该方法在一个大型商业数据中心成功部署,并在 2024 年一整年的范围内进行了一系列实验,安全高效运行累计时长超 2000 小时。
3.1 能效对比:显著优于传统 PID 控制器
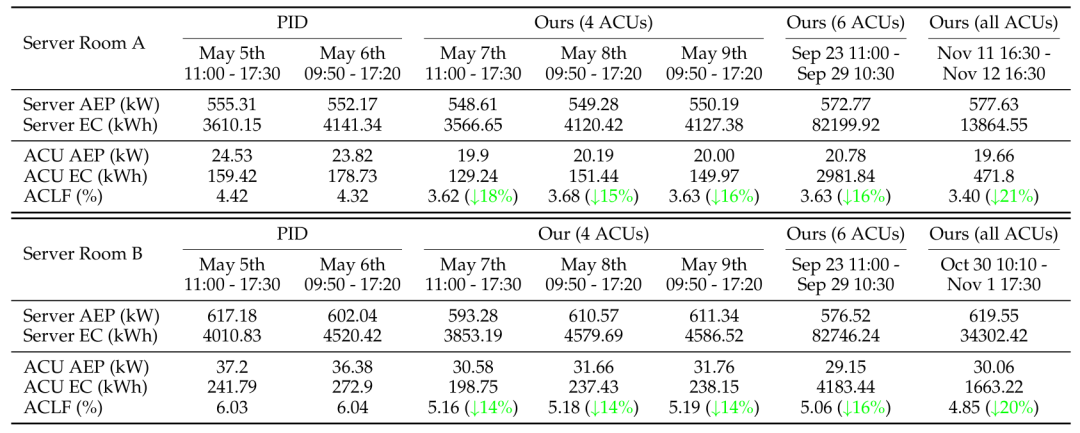
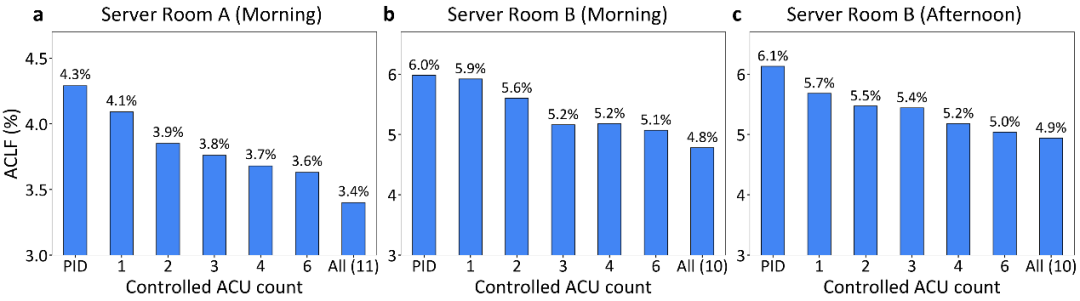
实验对比了该方法与传统工业 PID 控制器在能耗指标上的表现。模型控制了两个服务器机房(机房 A 和机房 B)的部分及全部空调单元(ACU)。评估采用数据中心行业广泛使用的 ACLF 指标(空调能耗与服务器能耗的比值,ACLF 越低表示末端冷却系统能效越高):
| 机房 | PID 控制 ACLF | 本方法 ACLF | 能效提升 |
|---|---|---|---|
| 机房 A | 4.32%–4.42% | 3.40%–3.68% | ↓15%–21% |
| 机房 B | 6.03%–6.04% | 4.85%–5.19% | ↓14%–20% |
在测试的两个机房中,新方法在不违反任何热安全规定的情况下,将冷却系统的能效提高了 14% 到 21%。
3.2 长周期连续控制表现
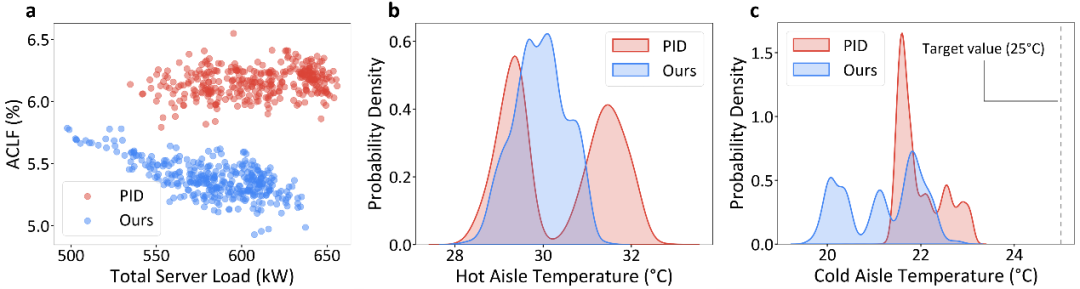
研究还进行了两次为期 14 天的实验,通过持续运行离线强化学习策略和 PID 控制器,分别控制机房 B 中的 4 个可控空调:
- 能效:模型的 ACLF 值在所有服务器负载条件下始终低于 PID 控制器,且在较高的服务器负载下节能效果更显著;
- 温度分布:在冷通道温度均满足低于目标值(25°C)的前提下,模型控制下的热通道温度分布比 PID 更集中、更均匀,有效改善了传统控制方式下热通道温度分布不均的问题。
3.3 AI 控制越多,节能潜力越大
通过让模型控制机房内从 1 台到全部 10 或 11 台的精密空调,进一步研究其节能效果。结果显示:随着更多空调被 AI 模型接管控制,能效呈逐步提升趋势(例如机房 A 上午时段,ACLF 从 PID 的 4.3% 单调下降至全量控制时的 3.4%)。这表明基于离线强化学习的控制方案具有很好的可扩展性,控制更多空调可实现更大程度的能效提升。
3.4 与基线方法的对比
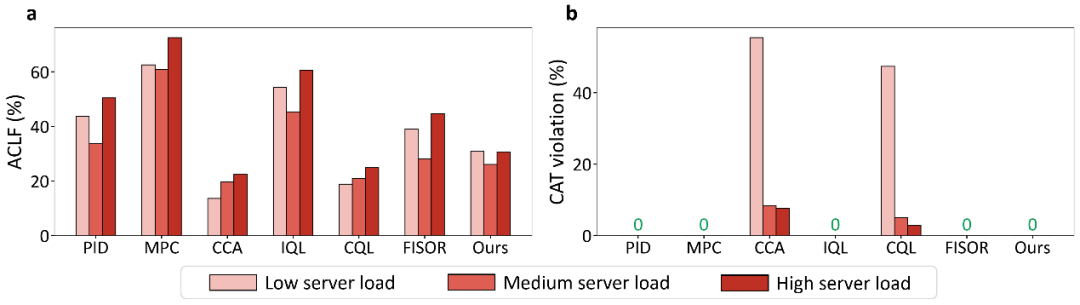
研究还搭建了一整套包含 22 台真实服务器及精密空调的小型测试平台,将提出的方法与其他基线方法进行了更充分的对比:
- 成熟工业控制方法:PID、MPC;
- 基于在线强化学习的定制化数据中心冷却系统优化方法:CCA;
- 前沿离线强化学习算法:IQL、CQL、FISOR。
对比结果:CCA 和 CQL 存在明显的冷通道温度约束违反(CCA 在低负载下违反率超 50%);排除这两个不安全的方法后,本方法在低、中、高三种服务器负载条件下的节能效果均明显优于其余所有基线方法,且全程无温度约束违反。
四、总结
本项研究首次展示了小样本、高泛化离线强化学习方法在真实数据中心环境下实现长周期、稳定可靠闭环运行的可行性,在解决广泛的工业及新兴高能耗系统控制优化问题中具有巨大的潜力,为数据中心的节能减排提供了新的技术解决方案。